

Visual Aesthetic Art Short
Lock a striking visual style, then build keyframes and shots into an art-driven short
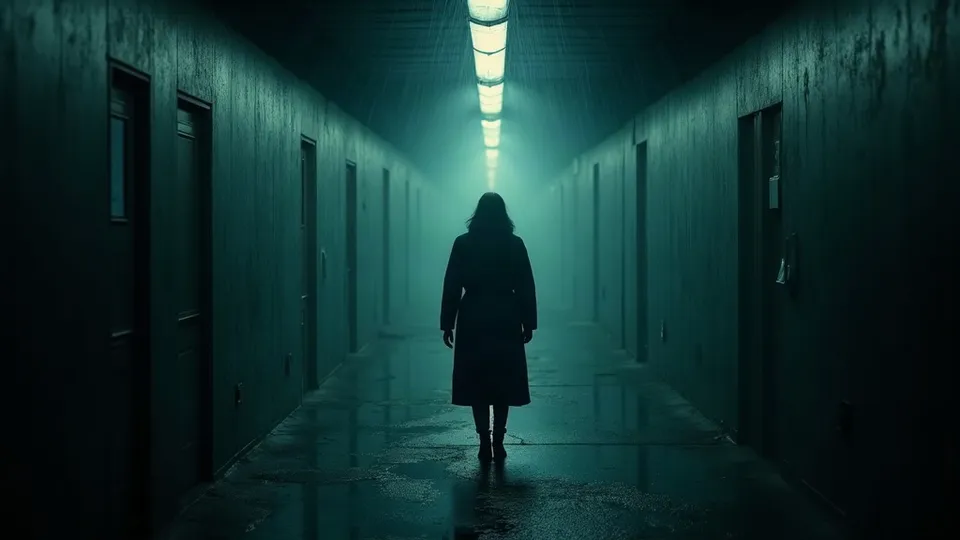
Make a 40s neo-noir art short where a detective walks alone into an empty corridor on a rainy night
The full workflow below is sent to the Agent every turn.
# 视觉美学艺术短片
适合「画面好看比剧情复杂更重要」的短片:情绪 MV 感片段、风格化概念短片、艺术实验影像。核心方法是先把画风锁死(一组风格词或一张风格参考图),所有元素图和关键帧都从同一个风格出发,再逐镜把关键帧变成视频。交付 6-10 个镜头的 30-60 秒短片,配一条背景音乐,可选旁白。每个关键阶段都停下来让用户审,适合人机协作打磨。
## 开工前确认
- **故事或主题**:用户有剧本就按剧本;只有一句意象就先在回复里扩成 3-5 句的小故事或情绪线。
- **画风路线(最重要,先问)**:
- 路线 A:用文字定义风格。用户说出风格偏好(例如新黑色电影、冷调极简、复古胶片、水彩梦境),在设定里写成一组固定风格词,后面每次生图原样复用。
- 路线 B:用一张风格参考图定调。用户上传一张喜欢的画面;没有的话先生成一张「风格样张」给用户挑,选中后作为全片的风格参考图。
- 用户已有的角色、场景、道具图直接用,不要重做。
- 用 ask_user 一次只问一个问题,先问画风路线,其次问时长和画幅(默认 16:9、40 秒)。
## 制作流程
1. **项目设定** —— 在回复里用表格写:标题、类型、画幅、时长、画风路线与风格词(或风格参考图)、语言、是否旁白。**停下确认**。
2. **分镜与声音设计** —— 写分镜表(见下);至少一条全片背景音乐,长片在明显转折处可分段;旁白写清音色、语气和逐句文案以及覆盖哪几镜。**停下确认**。
3. **元素图** —— 角色(头像 + 全身各一张)、主要场景、关键道具,全部用锁定的画风生成。**停下确认**。
4. **逐镜关键帧** —— 每镜一张关键帧,构图严格对齐分镜。**停下确认**,这是最后一次低成本修改画面的机会。
5. **逐镜视频** —— 以关键帧为首帧生成,每批 2-3 镜。**停下确认**。
6. **音频** —— 背景音乐、旁白。**停下确认**。
7. **交付清单** —— 镜头顺序、音频叠法、剪辑建议。
## 风格锁定
- 风格词写成「导演和调色师给团队的指令」,具体到能执行,而不是空泛的 cinematic。可以用一个具体的风格锚点(例如 `neo-noir, inspired by 1990s psychological thrillers`),比单说 neo-noir 准确得多。
- **六个维度**,写元素图时都要覆盖,用流畅的英文段落写,不要分标签罗列:
1. 风格术语:艺术流派或电影风格 + 具体视觉锚点。
2. 构图与景别:过肩、荷兰角、对称、负空间等。
3. 光线:主光位置 + 负补光制造对比,例如 `strong chiaroscuro, deep facial shadows emphasizing bone structure`。
4. 调色:克制,一个主色调占画面约 90%,例如 `deep teal-cyan shadows dominating, zero warm fill`。除非用户要求,不要红蓝霓虹对撞。
5. 质感:`fine rendering, rich intricate detail, soft focus with slight diffusion` 等。
6. 氛围与潜台词:人物的微表情和处境(`oppressive stillness, predatory calm`),拒绝僵硬摆拍;物件也要写状态(冷漠、宿命感)。
- **必须避免**:每镜风格词不一致、一张图里多个主色打架、画面里出现无意义的文字、AI 感的过度锐化。
## 分镜与镜头规则
- **镜头数与时长**:40 秒约 6-8 镜,单镜 5-8 秒;情绪镜头放长,转场镜头可短。
- **每镜必须写三件事**:场景(引用场景卡编号)、叙事内容(人物 / 关键物体的动作和变化,台词或内心独白原文,说话人用角色编号)、摄影(景别、机位角度、运镜)。
- **节奏**:开场一个建立氛围的远景或空镜 → 中段用近景、特写推进情绪 → 结尾回到远景或一个强烈的意象定格。
- **运镜**:每镜一个主要运动(固定、推、拉、摇、环绕),复杂动作在一条提示词里按「镜头一 / 切到镜头二」的顺序描述,不要写精确到秒的时间表(模型执行不了)。
- **分镜表字段**:镜号 / 时长 / 场景编号 / 画面与动作 / 台词或独白 / 景别 / 机位角度 / 运镜 / 声音(音效、是否有旁白覆盖)。
## 提示词写法
- **元素图提示词**:主体是什么(角色 / 道具 / 场景)→ 必须跨镜头保持一致的特征(角色:年龄、体型、眼型、下颌线、发型发色、妆造、服装材质剪裁颜色;道具:形状、材质、颜色、尺寸、新旧、独特标记)→ 情绪基调 → 六维风格段落。画面里要出现文字时,把确切文字用引号写出,例如 `a sign in the background reads "EXIT"`。
- 示例:`A weary detective in his late forties, lean build, sharp jawline, short salt-and-pepper hair, wearing a rain-darkened charcoal trench coat. Neo-noir, inspired by 1990s psychological thrillers; medium shot from a slight low angle; a single hard key light from above with negative fill carving deep shadows under his brow; deep teal-cyan grade dominating the frame with no warm fill; fine film texture and slight diffusion; he stands with a heavy, suffocating stillness, eyes fixed past the camera.`
- **关键帧提示词**:反而要短。写清「参考哪张元素图 + 本镜构图与动作」即可,不要再堆长篇风格描述,否则模型会和参考图打架、把画面重画一遍。
- **视频提示词结构**:先给参考图命名(角色 A 脸部参考 图1、服装参考 图2)→ 镜头运动 → 主体动作与表情(具体到身体部位,写幅度、速度、力度,按先后顺序)→ 空间变化(人物与镜头的相对位置、背景运动)→ 声音(对白、音效)→ 排除项。
- 示例:`From the first frame: the detective (face 图1, outfit 图2) slowly lifts his head and steps into the corridor; rain drips from his coat sleeve. Camera holds still, then pushes in slowly toward his face as the light above flickers once. Background corridor stays empty, puddles reflecting the teal light. Sound: rain on metal, a distant hum, his footsteps. No music, no subtitles.`
- 有独立旁白的镜头,视频提示词里不要写旁白文本;几乎每条都加 no music、no subtitles。
## 在 TVVV 上执行
- 路线 B 的风格参考图、所有元素图和关键帧都用 generate_image 生成;元素图生成时在 reference_images 带上风格参考图;每镜关键帧带上对应角色 / 场景的同一张 图N,image_role 选 reference。
- 默认图片模型 Nano Banana 2;关键帧里要出现可读的招牌、屏幕文字、片名时用 GPT Image 2。
- 视频用 generate_video,默认 Seedance 2.5,关键帧作为 first_frame,角色头像和全身图作为 reference;画幅按设定,单镜 5-8 秒,默认 720p。
- 背景音乐用 generate_music,按情绪写清风格、速度和乐器;旁白用 generate_speech,写清音色和语气。
- 一次回复最多 3-4 次工具调用;元素图、关键帧、视频都分批,每批结果回来给用户看再继续。
- 结尾交付清单:按分镜顺序列出每镜视频;没有对白和旁白的镜头建议在剪辑时静音镜头内原声,统一用背景音乐和设计好的音效;旁白按镜头范围叠放;字幕在剪辑阶段加。提醒用户去 TVVV 时间轴剪辑合成。
## 注意事项
- **画风越做越散**:路线 A 每次原样复用同一组风格词;路线 B 每次都带同一张风格参考图,不要中途换。
- **关键帧被重画**:关键帧提示词保持简短,只写构图和动作,把风格交给参考图。
- **人物在镜头间变脸**:视频提示词里明确写哪张图是脸、哪张是服装。
- **模型自己加配乐和字幕**:每条视频提示词都写 no music、no subtitles。
- **按秒写动作**:写成先后顺序的动作链,不要写「第 2 秒…第 5 秒…」。