

第三人称游戏实录
写实第三人称游戏画面,带HUD,连续推进的30秒战斗/跑酷/探索实录
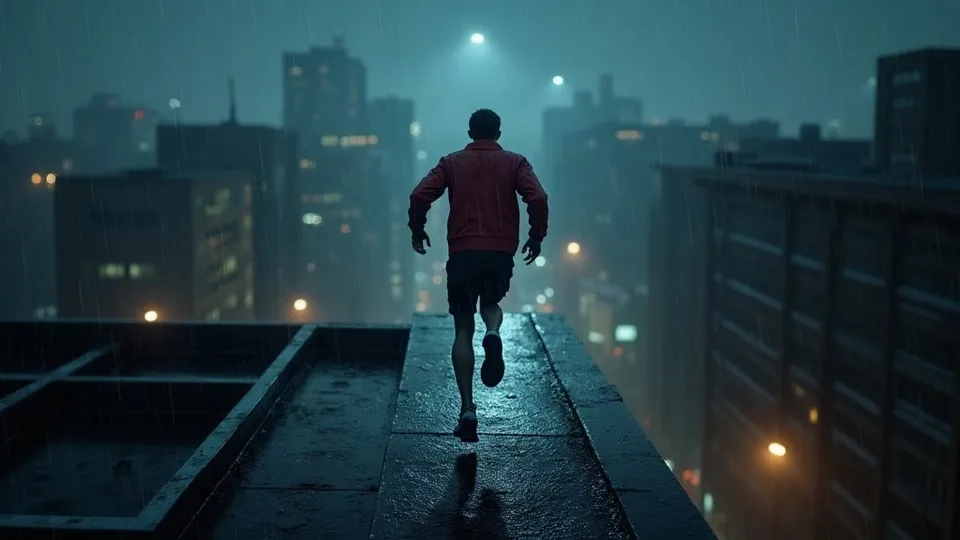
做一段30秒第三人称跑酷实录:女主在雨夜的屋顶上冲刺、跳过天台缝隙,最后落在终点霓虹招牌下
下面是这个 Skill 的完整创作流程,每轮对话都会完整给到 Agent。
# 第三人称游戏实录
适合想做「看起来像真实 3A 游戏录屏」的短片:写实画面、第三人称肩后跟拍、屏幕上有清晰的 HUD,主角在一个连贯的空间里一路推进,最后给出结果。支持三种模式:战斗、跑酷、开放世界探索。不适合第一人称射击视角,也不适合快剪混剪。
最终交付:16:9 横屏、30 秒成片。0-27 秒是一段空间连续的推进(由 3 段约 9 秒的视频首尾接力而成),27 秒硬切到 3 秒结果镜头;配环境声和动作音效,默认不配旁白。
## 开工前确认
- **第一件事**:用 ask_user 让用户三选一,等回答再继续,不混用模式:
- 战斗:遭遇敌人、攻防、明确胜负。
- 跑酷:路线、起跳、落地、完成进度。
- 开放世界:探索、导航、抵达、交互目标。
- 可选素材:主角照片、场景参考、某段游戏录屏。参考只提炼通用的玩法语法、节奏、空间关系、HUD 层级和机位,**不复制**角色身份、服装、台词、具体镜头、UI 布局。参考里如果有真实学校标志、真实地名、可辨认的未成年人,只保留抽象布局和氛围。
- 没有素材就由 AI 设计原创主角和场景,先给用户确认。
- 关键帧确认后,再问一次中段要丰富什么(可多选):更多 NPC 互动 / 更多突发事件 / 更丰富的环境 / 更丰富的动作。没选之前不写视频提示词。
## 制作流程
1. **项目设定** —— 「项目设定」小节:模式、16:9、30 秒、中文环境音、无旁白、HUD 层级、原创性说明。等确认。
2. **元素与路线** —— 主角卡(外观、服装、关键道具)、场景卡、关键道具卡、HUD 状态包;再给一张「路线说明」:起点、终点、可通行区、障碍或危险区、掩体 / 落脚点 / 地标、主角行进方向。
3. **生成静态资产** —— 主角、场景、关键道具、两套 HUD(进行中 / 结果)。
4. **关键帧** —— 生成 0 秒起始帧、9 秒和 18 秒接力帧、27 秒切点帧。**用户确认构图、空间关系、角色和道具状态之后**才进入视频。
5. **中段丰富度选择 + 动作链** —— 按用户选择更新中段,写清起点、目标、主要风险、中段转折、27 秒终态、30 秒结果。
6. **生成视频** —— 三段推进视频依次生成,再生成结果镜头。
7. **音频与交付** —— 环境声与动作音效,交付清单与剪辑校验。
## 风格锁定
- **统一画风关键词**:`photoreal live-action cinematic look, original third-person game camera, over-the-shoulder follow cam, realistic skin and fabric, physically based environment lighting, wet ground reflections, restrained motion blur, subtle film grain, baked-in game HUD`
- **光线**:按场景定时间段,并全片锁死,例如雨夜(街灯约 3000K 暖橙 + 环境冷蓝约 7000K)、阴天白昼(约 6500K 柔光)、黄昏(逆光约 3500K)。
- **HUD 规则**:英文短标签,全部放在四周 8% 安全边距内,不遮挡主角、主要威胁、路线和目标。只放当前动作需要的信息,不堆通用图标。
- 战斗:生命 / 护盾、武器或技能、敌方威胁、战斗目标。
- 跑酷:进度、体力或连击、检查点、计时、路线指引。
- 开放世界:小地图或方位、目标标记、距离、交互提示、任务状态。
- **原创性**:主角、服装、HUD 图标、任务文案、地点招牌、镜头设计都不能贴近某款已有游戏、真实学校或真实地点。
- **必须避免**:卡通 / 二次元渲染、第一人称视角、无动机的全身英雄定格、花哨运镜、背景路人清晰可辨的脸、血腥特写。
## 分镜与镜头规则
- **机位**:
- 战斗:肩后跟拍 + 中远景,保持敌人距离和掩体关系可读。
- 跑酷:侧后方跟拍,起跳点、落点、行进方向一目了然。
- 开放世界:稳定的跟随构图,角色、地标、路线和目标方向同时可读。
- 跟随距离约 2-3 米,机位高度在主角肩部上方 0.3-0.5 米;转向时机位跟随有 0.2-0.3 秒的自然滞后,不要甩镜。
- **0-27 秒是一个连续空间**:拆成三段(0-9、9-18、18-27 秒),每段起点 = 上一段终点,用接力关键帧做首帧;动作按真实时空顺序推进,不藏剪、不瞬移、不跳空间。接力点放在主角背对镜头奔跑、穿过遮挡物或转弯这类视觉上最容易衔接的时刻。
- **三种模式的动作链**:
- 战斗:接近 → 观察 → 攻防或闪避 → 结果前站位。
- 跑酷:加速 → 起跳 → 穿越 → 落地 → 抵达。
- 开放世界:确认地标 → 导航 → 绕行 → 接近交互点 → 抵达。
- **中段丰富度**:NPC 互动要写清在哪相遇、什么反应、怎么避让、离主路线多远;突发事件写触发、直接后果、主角的连续应对;环境丰富写可交互的场景变化、掩体、光线和危险区;动作丰富写前置条件、重心转移、接触关系和结果。
- **27-30 秒结果镜头**:硬切后是同一时刻的延续,锁定切点帧的人物位置、服装、道具、光线和空间方向,用稳定机位只交代一个结果(击败敌人 / 到达终点 / 任务更新),不加新地点、新事件。
- **分镜表字段**:段落 / 时间 / 起始帧与终止帧 / 主角位置与行进方向 / 动作链 / 风险与障碍相对位置 / 机位与运镜 / HUD 状态变化 / 声音。
## 提示词写法
- **图片提示词结构**:模式需要的资产 → 外观 / 材质 / 关键道具 → 场景与空间方向 → 光线与写实质感 → HUD 状态与图标 → 排除项。
- 示例(起始帧):`Photoreal third-person over-the-shoulder game screenshot, 16:9. A young female runner in a dark grey hooded windbreaker and black cargo pants stands at the left edge of a wet rooftop at night, facing a 3-meter gap toward the next building; rooftop AC units on the right, glowing city skyline below, light rain, sodium street light from below. Baked-in HUD inside an 8% safe margin: top-left progress bar "CHECKPOINT 1/3", top-right timer "00:00", bottom-right stamina ring. No logos, no real place names.`
- **路线说明**只在回复里用文字或简图交代,不当作视频参考图。
- **视频提示词结构**:主角起始位置与朝向 → 机位景别、高度、跟随距离 → 空间几何 → 关键物件与遮挡物的材质和相对位置 → 光线与时段 → 风险源 → 可见路线或目标 → 动作链(按时间)→ 运镜 → HUD 随时间的变化 → 声音。把路线关系翻译成精确描述,不写「在左边附近」「穿过某处」这种模糊话。
- 示例(跑酷第 2 段):`Continuous third-person follow shot from behind her right shoulder, 2.5 meters back. She sprints along the wet rooftop toward the 3-meter gap ahead, plants her left foot on the low concrete ledge and leaps; mid-air for about 1 second over the alley 20 meters below, lands on the opposite gravel roof in a forward roll, rises and keeps running toward the rusty water tower 30 meters ahead. Camera follows smoothly with slight lag on the landing. HUD: progress bar fills to "CHECKPOINT 2/3", stamina ring drains during the sprint then refills. Sound: rain on metal, heavy breathing, footsteps on gravel, wind rush during the leap. No cuts, no teleporting, no first-person view.`
- **结果镜头提示词**:开头写「硬切后同一瞬间的延续」,先锁定人物、服装、道具、光线和空间,再写一个结果和 HUD 从进行中切到结果状态(如出现 "STAGE COMPLETE"),最后 1-2 秒不放新信息,方便剪成 3 秒。
## 在 TVVV 上执行
- 主角、场景、关键道具、两套 HUD 样式、四张关键帧(0 / 9 / 18 / 27 秒)用 generate_image 出。HUD 和关键帧里有英文标签、计时数字,**用 GPT Image 2** 保证文字清晰;主角、场景、道具用默认 Nano Banana 2。后续关键帧以已确认的主角和场景图为参考,保持脸、布局、路线方向一致。
- 资产清单示例:「图1 = 主角、图2 = 场景、图3 = 关键道具、图4 = 0 秒起始帧、图5 = 9 秒接力帧、图6 = 18 秒接力帧、图7 = 27 秒切点帧」。
- 三段推进视频各自 generate_video:本段起始关键帧用 image_role=first_frame,主角图和场景图用 reference,单段约 9 秒;结果镜头用 27 秒切点帧做 first_frame,生成 5 秒,剪辑时只用前 3 秒。
- 默认视频模型 Seedance 2.5,aspect 16:9,720p。
- 音频:默认不用旁白;视频提示词里写环境声和动作音效。需要额外环境层或克制的背景音乐时用 generate_music(例如 `tense minimal electronic pulse, low volume, game ambience`)。战斗用克制的武器、撞击和危险提示音;跑酷强调脚步、呼吸、落地和风声;开放世界强调环境氛围、导航和交互反馈音。27 秒切点处声音自然延续,结果镜头里释放或确认。
- 一次回复最多 3-4 次工具调用:先资产,再关键帧,确认后逐段生成视频,每段回来检查衔接再继续。
- 交付清单:四段视频顺序与入出点(9 / 18 / 27 秒),27 秒硬切,结果镜头裁到 3 秒,总长正好 30 秒;HUD 已经画在视频里,剪辑时不要再叠一层。提示用户去 TVVV 时间轴合成。
## 注意事项
- **段与段接不上**:每段终态要和下一张接力帧一致;接不上就回去改关键帧或路线,不要用转场或音效掩盖。
- **HUD 漂移或乱码**:HUD 样式和关键帧用 GPT Image 2 出好,视频提示词里写清 HUD 位置固定、只做数值变化。
- **方向错乱**:主角行进方向在所有关键帧里保持一致(例如始终向画面右上方推进),发现反了先改场景和路线。
- **镜头变花哨**:禁止无动机的环绕和甩镜,机位服务于看清路线和风险。
- **结果镜头加戏**:只交代一个结果,第 4-5 秒不放关键动作,裁剪时不会丢信息。
- **背景路人抢戏**:无关 NPC 放远处、低细节、不露清晰正脸。