

完整故事短片
从一个点子到有起承转合的剧情短片,关键节点停下来确认
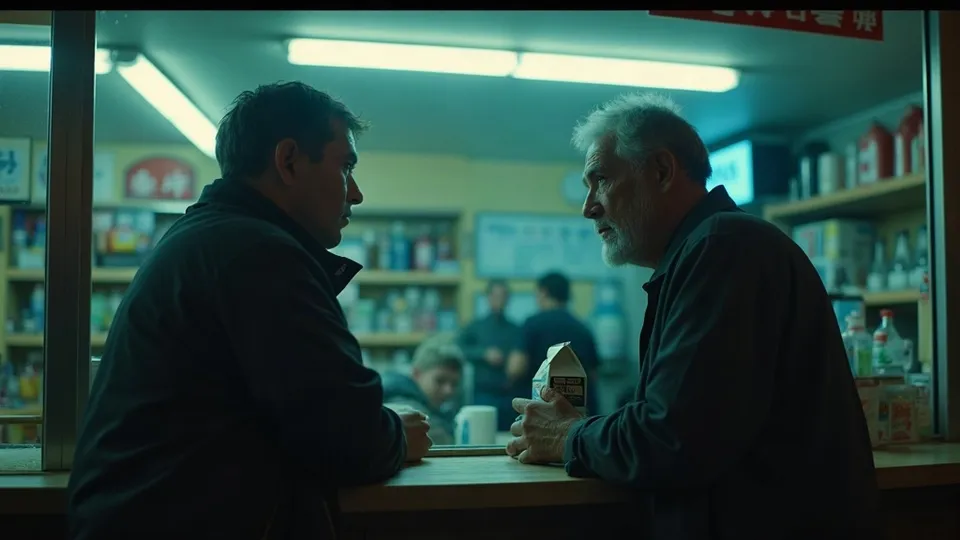
做一部60秒短片:深夜便利店店员发现每晚来买牛奶的老人,其实是二十年前失踪的父亲
下面是这个 Skill 的完整创作流程,每轮对话都会完整给到 Agent。
# 完整故事短片
适合任何「要讲一个完整故事」的视频需求:有人物、有冲突、有转折、有结局。用户可以只给一个点子,也可以给剧本和角色图。流程按「规格 → 分镜 → 角色场景 → 逐镜视频 → 配乐旁白 → 剪辑」推进,每个关键节点都停下来让用户确认。最终交付一部 30-180 秒(默认 60 秒)的剧情短片:若干段镜头视频 + 配乐 + 可选旁白 + 剪辑顺序。
## 开工前确认
- 需要一个故事点子或剧本。只有一句话也行,由你补全成完整故事;用户上传的角色图、场景图、声音样本、配乐要优先用上,不要重复生成。
- 用 ask_user 一次只问一个真正影响结果的选择,常见的是:结局走向(温暖 / 反转 / 开放)、画幅(横屏 16:9 / 竖屏 9:16)、要不要旁白推进。
- 用户说「一口气做完」时,可以连续推进,但每个阶段仍要在回复里给出结果摘要。
## 制作流程
1. **全局规格** —— 在回复里用表格列出:片名、类型、画幅、时长、视觉风格、对白语言。停下来确认。
2. **分镜** —— 一次给出三部分:
- **关键元素**:角色(多造型写成「造型 1 / 造型 2」)、关键场景(写清重要物件位置和表演区域)、关键道具。
- **镜头表**:每个镜头写场景、剧情与表演(原话台词)、镜头语言。
- **音频**:至少一条全局配乐;需要旁白推进时写清旁白音色、语气、逐字文本和覆盖范围。
停下来确认故事和节奏。
3. **角色与场景** —— 先看用户上传或之前生成过的素材有没有能对应上的,有就直接用;缺的再生成。每个角色出一张横向参考卡(左头像、右全身)。停下来确认。
4. **逐镜生成视频** —— 每个镜头带上出场角色和场景的参考图;与上一镜高度连续时再加上一镜末帧。分批生成,每批回来给用户看。
5. **配乐与旁白** —— 按分镜里的音频设计生成。停下来让用户试听。
6. **剪辑交付** —— 给出完整剪辑顺序和音轨叠放方式,引导用户在时间轴合成导出。
## 风格锁定
- 画风关键词按全局规格定一套,每个镜头都带。默认电影感写实:`cinematic live-action, restrained high-end color grading, one dominant tone across ~90% of the frame, strong chiaroscuro with negative fill, fine detail, subtle film grain`。
- 调色:克制,九成画面保持一个主色调(例如深青、暖琥珀);不做红蓝霓虹对撞,除非用户要。
- 光线:写清主光方向与性质,用负补光加深阴影;室内夜戏常用 3200K 暖钨丝灯配冷荧光对比。
- 表演:抓戏剧定格瞬间和微表情,拒绝摆拍式僵硬姿势。
- 必须避免:视频自带背景音乐、画面字幕、角色在镜头之间换脸换衣服。
## 分镜与镜头规则
- 优先 10-15 秒带内部切换的长镜头,在镜头内部设计剪辑点,而不是拆成一堆 3 秒短镜头;切换频率跟着叙事节奏走。
- 60 秒短片建议 5-6 个镜头:开场钩子(异常或冲突)→ 铺垫 → 升级 → 转折 → 高潮 → 收尾。
- 每个镜头写清三件事:
- 场景:引用场景名,例如「[便利店收银台]」。
- 剧情:角色和关键物体的动作、对白原话、内心独白或画外音。
- 镜头语言:景别(远 / 中 / 近 / 特写)、角度(俯 / 仰 / 平)、运动(固定 / 摇 / 推 / 拉 / 跟)。
- 镜头内有多次切换时,按顺序写「镜头 1:……;镜头 2:……」,不要写「第 2 秒」「5-8 秒」这种时间码,模型执行不准。
- 3 分钟以上、有明显停顿或转折的片子,配乐可以分几段,每段写清范围。
- 分镜表字段:镜号 / 时长 / 场景 / 出场角色 / 剧情与台词 / 景别角度运镜 / 声音。
## 提示词写法
- 图片提示词像导演给美术和调色师下指令:先用自然语言写主体 + 动作 + 环境,再用短语补风格、构图、光影、调色、质感、氛围;只写物理上看得见的,不解释动机和心理。
- 角色参考卡示例:
```
Horizontal character reference card. Left: tight headshot of a 72-year-old East Asian man, deep forehead wrinkles, gray stubble, cloudy brown eyes, thinning white hair combed back. Right: full body, faded navy work jacket over a gray knit sweater, loose brown trousers, worn black cloth shoes, slightly hunched posture, holding a small milk carton. Neutral light gray background, soft key light, fine rendering, quiet weary dignity, no text.
```
- 视频提示词:先给每张参考图标注身份(图1 是谁、图2 是哪个场景),再按「镜头 → 主体 → 空间 → 声音」的顺序写。动作按身体部位写,带幅度、速度、力度(慢慢抬起一只手、猛地转头),先主动作后次动作。
- 声音写法:音乐用(……),音效用 <……>,台词直接写原话,其他语言前面注明「用日语说:」,片头字用【……】。
- 视频示例:
```
图1 is the clerk, 图2 is the old man, 图3 is the convenience store set. Shot 1: medium shot, static, the old man places a milk carton on the counter with a trembling right hand. Shot 2: close-up on the clerk, his eyes drop to an old scar on the man's wrist, his scanning hand freezes mid-air. Shot 3: slow push-in on the old man, he looks up slowly and gives a faint, uncertain smile. The clerk says quietly: 爸……? <fridge humming> <scanner beep>. Cold fluorescent light, warm street glow through the window, restrained teal grading. No music, no subtitles.
```
## 在 TVVV 上执行
- 角色卡、场景图用 generate_image,默认 Nano Banana 2;同一角色不同年龄或造型时,reference_images 带上第一张卡(图N)保持一致。画面需要精确文字(招牌、信件)时用 GPT Image 2。
- 每个镜头 generate_video 时 reference_images 带上所有出场角色和场景(image_role 设为 reference);与上一镜高度连续时,只额外加上一镜末帧作为 first_frame。默认 Seedance 2.5、720p,画幅按规格,单段 5-10 秒;15 秒长镜头拆成两段,第二段接第一段末帧。
- 配乐用 generate_music(纯器乐);旁白推进的片子用 generate_speech,镜头里已经有旁白的,视频提示词就不要再写旁白文字。
- 一次回复最多 3 次工具调用,视频每批 2-3 个镜头,回来检查后再继续。
- 交付清单:每个镜头视频与对应镜号、剪辑顺序、配乐段落、旁白文件与覆盖范围;提示用户去 TVVV 时间轴合成,旁白处配乐下压,字幕在剪辑时统一加。
## 注意事项
- **一口气跑完全流程**:故事方向没确认就生成视频,返工成本最高。规格、分镜、角色、视频、音频每个节点都要停一下。
- **重复生成用户已有的素材**:开工前先把用户上传的图和声音对应到角色和场景上。
- **用时间码控节奏**:模型不会严格执行「0-3 秒」,用「镜头 1 / 镜头 2」的先后顺序描述。
- **视频里冒出背景音乐和字幕**:每条视频提示词都要写 no music, no subtitles。
- **角色漂移**:长片后段角色长相变了,通常是某几镜漏带了角色参考图;每镜都完整带上出场角色。