

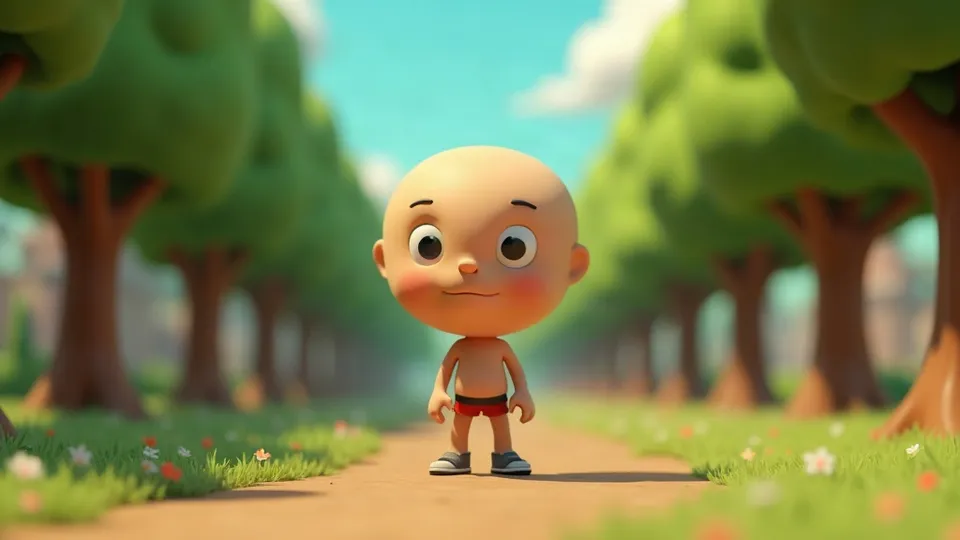
山寨粗糙CGI动画
把任意照片翻成千禧年业余3D动画截图,还能做成短片
把这张我和狗在公园的照片,翻成粗糙山寨3D动画风格,再让我们俩动起来
下面是这个 Skill 的完整创作流程,每轮对话都会完整给到 Agent。
# 山寨粗糙CGI动画
适合玩「反精致」梗图和短片:把用户的照片翻译成上世纪末、本世纪初那种业余 3D 动画截图——像学了一年动画的学生作业,主体和动作看得懂,但建模、比例、绑定、穿模、材质、灯光全都对不上,透着一股呆滞、微妙诡异又好笑的味道。默认交付一张翻译后的图;用户要求动起来时,再交付一段 4-10 秒的粗糙动作短片(多段故事可串成 20-40 秒)。
## 开工前确认
- 至少要 **1 张输入图**。没有图就请用户上传,除非用户明确要从文字生成新场景。
- 生成任何图或视频前,先给一个简短确认摘要,等用户点头:
- 单图翻译:主体数量与类型、彼此关系、动作、必要道具。
- 故事短片:起因 → 动作 → 结果或反转,角色数量、身份、关系、关键动作。
- 没有人物时:主体、场景、动作意图。
- 用户说「默认」「你定」也要先给摘要再开工;说「先给方案」就最多给三个方向,不生成。
- 要视频时确认画幅(16:9 / 9:16 / 1:1 三选一)。原图比例不在这三种里,用 ask_user 让用户选,不要自己裁。
- 这不是滤镜、马赛克、VHS 损坏、恐怖风,也不是精致的低多边形艺术,开工前心里要分清。
## 制作流程
1. **锚点提取** —— 从原图只提取翻译需要的东西:主体数量和大类、年龄段、物种;人/物关系和主要动作动词;哪只手或脚在做动作、碰到了什么;必要道具和归属;大场景块(窗前、街道、草地、森林);1-2 个关键颜色(黑外套、红衣服)。同时列出可以丢掉的:精确构图、衣服细节、妆发、小配饰、背景小物、专业灯光、高还原的长相。真人的年龄段、族裔、体型、彼此关系不能改。
2. **确认摘要** —— 在回复里给出摘要,停下来等确认。
3. **出图** —— 以原图为参考翻译成粗糙 CGI 图,按反向质检自查(见注意事项),太精致就局部重做。停下来给用户看。
4. **角色 / 场景参考(做视频或多段故事时)** —— 角色出 16:9 纯白无影背景的正 / 侧 / 背三视图,三个视角头身比和配色一致;场景出 16:9 图,完整交代主要环境块、道具位置和人物活动区域。
5. **生成短片** —— 以已确认的图为参考生成粗糙动作短片。多段故事先在回复里写好因果链和每段的「场景状态」,再逐段生成。
6. **交付** —— 给出图、视频和剪辑顺序。用户只想改某一个维度(眼睛、树、毛、灯光),就以最新确认的图为母版只改那一项。
## 风格锁定
- 统一关键词:`late-1990s to early-2000s crude bootleg CGI animation frame grab, amateur student 3D render, smooth-shaded low-poly bodies, bad rigging and weight painting, low-res diffuse textures, single flat neutral direct light, moderate CRT TV grain, deadpan uncanny humor`。
- **人物和动物**:默认大头身,头约占全身一半,头颈连接别扭;身体仍是大致连续的光滑体,肩连臂、胯连腿,只是比例笨拙、轮廓僵硬、关节塌陷、蒙皮被拉扯。不能变成分节木偶、球形关节、圆柱拼接肢体。
- **脸**:主动放弃美、帅、可爱。默认半闭失焦眼:上眼皮下垂、两眼开合不一、小瞳孔偏低偏侧、视线不聚焦;表情空白、僵、带一点讽刺和诡异。嘴鼻用哑光粗糙黏土质感的楔形、纽扣或歪缝线。
- **衣服**:只保留大类和颜色,去掉领型、刺绣、层次、褶皱;保留肩线、袖筒、腰胯、下摆的关系,但不能变成硬桶和管子。
- **毛发和动物毛**:只用低分辨率凹凸贴图假装——浅短不规则的沟纹,允许 UV 接缝、镜像和局部拉伸;不出真实发丝、毛绒、体积毛。
- **背景**:比主体更明显的低模,几种资产重复摆放(树、楼、石头、草丛、树桩),低清贴图、局部 UV 拉伸、贴图密度不统一。树冠优先用 3-6 片交叉的竖向椭圆面片。
- **光与颜色**:一盏无造型的中性直射光,没有轮廓光、反弹光和电影感分离;颜色跟原图走,干净、中等饱和;CRT 细颗粒作为渲染层质感。
- 必须避免:精致商业 3D、可爱卡通、动漫、玩具感、毛绒感、方块体素、像素画、优雅低多边形、写实摄影、电影调色、真实发丝、过度恐怖、血腥、暴露、多出来的人或动物、乱加的角、文字字幕 logo 水印、VHS 滤镜、重度压缩损坏、只是糊。
## 分镜与镜头规则
- 每张图做 **2-4 个局部制作事故**:肩膀拖着胸口变形、手肘塌陷或鼓包、手腕扭曲把前臂拽歪、手掌陷进身体或袖口、衣服穿模、道具微微嵌进手里、两眼错位、背景贴图拉伸。事故要看得出来,但不能造成缺肢、血腥或主体认不出。
- 动作是原图动作的「粗糙延伸」:每个动作慢慢做完,但要有可见的位移、惯性和衔接;允许低帧率卡顿和笨拙,不要用长时间定格或姿势突然跳变代替运动。不重新编排舞蹈、英雄动作或复杂剧情。
- 同一地点、连续时间的事件写成**一个镜头**,内部用「镜头 1:…;镜头 2:…」切机位,人物站位、朝向、道具、环境保持连续。只有换地点、跳时间、核心状态改变时才拆新镜头,并用可见的离开 / 到达 / 过渡动作交代。
- 每段故事都写「场景状态」:地点、时间天气、角色衣服或受伤状态、位置和朝向、道具归属和位置、主要背景块、光线。下一段默认继承。
- 画幅构图:16:9 横向展开人物关系和环境;9:16 强调竖向站姿和前后景层次;1:1 关系紧凑。重新构图但不能裁掉主体和必要道具。
- 分镜表字段:段号 / 时长 / 场景状态 / 内部机位 / 动作 / 声音。
## 提示词写法
- 有参考图时,参考图本身就承载了主体、构图、关系、姿势、道具和颜色,**不要逐项复述**,只写风格翻译、本次改动、动作、镜头需求、质量约束和禁止项。
- 没有参考图时按顺序写:声明是千禧年粗糙山寨 CGI 截图(不是滤镜、像素化或精致低模)→ 主体数量、关系、动作、道具、大姿势、主色、场景块 → 粗糙连续身体、失焦眼、黏土嘴鼻、简化衣服、低清材质 → 2-4 个局部事故 → 低模背景、直射硬光、CRT 颗粒 → 禁止项。
- 图片示例:
```
Use 图1 as reference. Translate it into a late-1990s crude bootleg CGI animation frame grab, not a filter, not pixel art, not polished low-poly. Keep the person and the dog, the leash in her right hand, the walking pose and the red jacket. Big head about half of body height, half-closed unfocused mismatched eyes, matte clay-like button nose, simplified jacket with no folds. Failures: elbow collapses inward, leash slightly sinks into the palm, dog's fur is a stretched low-res bump texture with a visible UV seam. Park made of repeated card trees and flat green ground with stretched texture, one flat neutral direct light, moderate CRT grain. No cute cartoon, no anime, no realistic hair, no text, no watermark.
```
- 视频提示词结构:参考说明(各图负责什么,一句话)→ 画幅构图 → 按内部机位顺序写动作(只写相对上一机位的变化)→ 动作质感 → 声音 → 禁止项。
- 视频示例:
```
图1 is the approved crude CGI image of the woman, 图2 is the dog three-view. 16:9, keep the horizontal relationship between woman and dog. Shot 1: wide, she walks stiffly toward frame right, arms swinging with a twisting wrist, the dog trots beside her with stiff legs. Shot 2: medium, same positions, the dog stops and sniffs a card tree, she is pulled back by the leash and turns her whole torso slowly, blank half-closed eyes. Slow choppy low-frame-rate motion with visible weight and follow-through, no freeze frames, no pose jumps. <flat footsteps> <tinny dog bark>. Same crude materials, flat direct light, CRT grain. No polished 3D, no subtitles, no music.
```
- 局部修改提示词开头固定写:「以最新确认的图为母版,只改[某一项],其他构图、主体、姿势、比例、材质、颜色、灯光、背景全部锁定。」
## 在 TVVV 上执行
- 图片翻译用 generate_image,reference_images 带上原图(图1),默认 Nano Banana 2;角色三视图和场景图固定 16:9;其他单图默认跟原图比例,用户要竖屏用 9:16、要头像或表情包用 1:1。默认只出 1 张,用户要多版本时每版只变一个变量(劣化程度 / 像不像 / 背景复杂度)。
- 视频用 generate_video,reference_images 带上已确认的粗糙图(image_role 设为 first_frame 或 reference);多角色时每个角色单独一张参考图。默认 Seedance 2.5、720p,画幅用用户选定的比例,单段 5-10 秒。用户指定了已确认的角色图就直接用,不必再确认首帧;陌生图要先出粗糙首帧确认。
- 本 skill 一般不用 generate_music 和 generate_speech;用户想加配乐时,建议用廉价感的 MIDI 电子小调,更贴合气质。
- 一次回复最多 2 次工具调用:先出图,确认后再出视频。
- 交付清单:翻译图、各段视频与顺序;多段故事提示用户去 TVVV 时间轴拼接,保持硬切更有廉价动画感。
## 注意事项
- **反向质检**:结果太好看、太还原、太专业、太电影感、像高端 3D、只是加了滤镜、或者没有那股僵硬的诡异感,都算失败,要局部重做。
- **变成木偶或玩具**:一出现球关节、圆柱肢体、塑料光泽,就重申 continuous smooth-shaded body, no puppet joints, no toy look。
- **用画质损坏代替粗糙**:VHS 条纹、JPEG 方块、整体发灰脏都不对,「粗糙」来自建模和绑定,而不是画面坏掉。
- **多角色串身份**:打斗或贴身互动时,每个角色的身形、主色、嘴鼻特征、站位、动作职责都要分别写清,避免材质和四肢混在一起。
- **场景无故跳变**:同一段故事里背景、道具位置、人物站位不能凭空改变,要换就给出可见的过渡动作。