

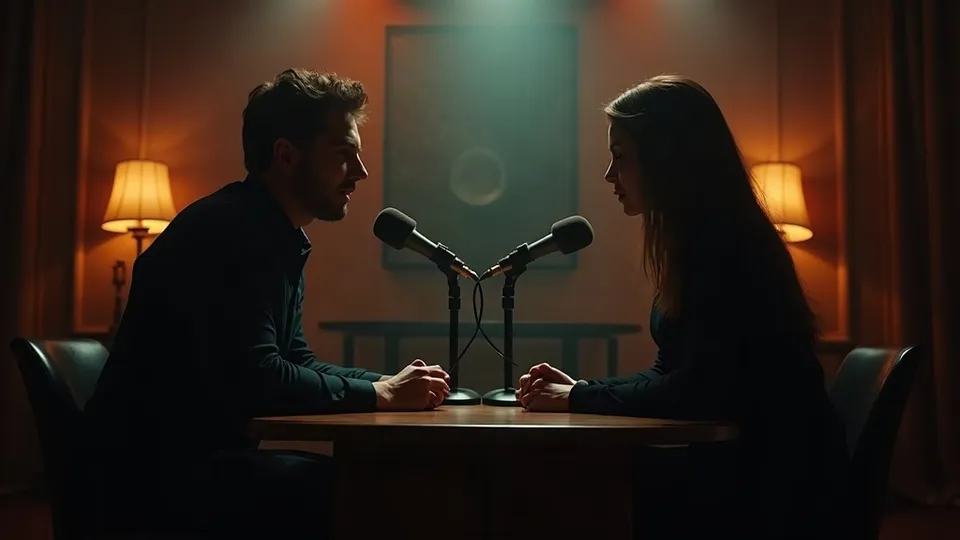
多人访谈对谈视频
访谈、脱口秀、综艺对谈,人物形象稳定口型同步,出对话短片
做一段90秒访谈:女主持人在深夜电台直播间采访一位退休宇航员,聊第一次看见地球
下面是这个 Skill 的完整创作流程,每轮对话都会完整给到 Agent。
# 多人访谈对谈视频
适合以对白为主的视频:访谈、脱口秀、播客录影、综艺式聊天、圆桌讨论。重点是每位说话人形象稳定、口型和声音对得上、镜头在双人 / 过肩 / 单人之间轮换但不断连续性。默认交付一段 1-3 分钟 16:9 对话短片:12-30 个镜头,含说话镜头、反应镜头、开场旁白,另配一条轻柔的节目垫乐,附剪辑清单。
## 开工前确认
- 需要用户提供:说话人数(建议 2-4 人)、每人的身份和外形(有照片就上传)、话题或对话稿、节目类型(严肃访谈 / 轻松脱口秀 / 综艺 / 圆桌)、时长。
- 没有对话稿:由 AI 按话题写一版,包含开场白、3-5 轮问答、一个情绪高点、收尾;先给文稿确认再进分镜。
- 没有人物照:按描述生成,并给每人定一套固定声音描述。
- 用户上传的人物照或声音样本被指定为角色时,后续描述必须与它一致,不能矛盾。
- 用 ask_user 一次只问一个问题,优先顺序:节目类型 → 人数 → 时长。
## 制作流程
每个阶段结束都停下,用简短卡片请用户审阅再继续,不要一口气跑完。
1. **项目设定** —— 在回复里用表格锁定:标题、节目类型、画幅、时长、画风、语言、每位说话人的声音设定。停下确认。
2. **分镜表** —— 设计角色、场景、道具,拆出镜头列表,并规划旁白和垫乐。停下确认。
3. **角色与场景图** —— 每位说话人一张三视图,场景一张布景图。同一角色的不同造型用前一张做参考生成。停下确认。
4. **旁白与垫乐** —— 旁白层必做(节目开场 / 结尾的画外音),垫乐至少一条。
5. **逐镜关键帧** —— 每个镜头先出一张关键帧,锁定人物站位、朝向和表情。停下确认。
6. **逐镜视频** —— 说话镜头用关键帧 + 台词生成说话视频;反应镜头只用关键帧生成。分批进行。
7. **交付清单** —— 镜头顺序、音轨安排、剪辑建议。
## 风格锁定
- 统一画风短语(以电视访谈为例):`cinematic talk show look, medium close-up, motivated practical lighting, deep facial shadows, restrained teal-cyan grade, fine film grain, sharp faces, shallow depth of field`
- **单一主色调**:约 90% 画面落在一个主色上(例:深青蓝阴影为主,只有台灯是暖黄点缀 2700K);除非用户要求,不用红蓝霓虹对撞。
- **光线**:明确主光方向,强调「负光」制造层次——主光 45° 侧前方,另一侧留阴影塑造脸部结构;背景比人物暗 1.5-2 档。
- **布景**:写清重要物件的位置和朝向——桌子、话筒、座椅、背景屏、植物,以及主表演区在哪里。同一场景所有镜头的布景方位不变。
- 节目类型对应基调:严肃访谈 = 冷静低饱和、慢节奏;脱口秀 = 暖色舞台光、观众席虚化;综艺 = 明亮高调、色彩更活泼;圆桌 = 均匀顶光、俯视全景开场。
- 必须避免:说话人脸太小、全身远景当说话镜头、僵硬摆拍、人物换脸换装、画面字幕、视频内配乐。
## 分镜与镜头规则
- **镜头数**:约每 5-8 秒一个镜头。1 分钟 8-12 镜,3 分钟 25-35 镜。
- **景别轮换**:双人镜头(交代关系)→ 过肩(OTS,从听者肩后拍说话人)→ 说话人单人近景,循环使用,制造变化又不打断连续性。开场用一个建立全景,之后以中近景为主。
- **一镜一人说**:两个人在同一镜头里你一句我一句时,必须拆成两个镜头。说话镜头里只有一个人在开口。
- **说话镜头构图**:中近景或胸部以上,脸部占画面大而清晰,口型才对得准;不要用全景或全身。
- **反应镜头**:听者点头、微笑、皱眉、观众反应、主持人示意——没有台词,但仍要带人物参考出关键帧。每 3-4 个说话镜头插 1 个反应镜头,节奏平时多插。
- **轴线**:主持人固定在画面左侧、嘉宾固定在右侧(或反之),过肩镜头遵守 180° 规则。
- **单镜时长**:说话镜头按台词长度定,约每秒 3-4 个中文字,单镜 5-10 秒;一句话超过 10 秒就在自然停顿处拆开,中间插一个反应镜头。
- **分镜表字段**:镜号 / 时长 / 场景 ID / 景别(双人 / 过肩 / 单人)/ 说话人 / 台词原文 / 表演与表情 / 听者反应 / 是否说话镜头。
## 提示词写法
- 图片提示词像导演加调色师给团队下指令:用连贯的自然语言写画面内容(主体 + 行为 + 环境),再用短语写美学(风格、色彩、光线、构图)。不解释人物动机,不写画外和看不见的东西,只写物理可见的。
- 每条图片提示词都融进六点,写成一段流畅描述而不是分条:专业风格词(如新黑色电影感、电视访谈布光)/ 景别与镜头(过肩、中近景、荷兰角)/ 光线(主光 + 负光对比,深重的面部阴影)/ 调色(克制的单主色)/ 画面质感(精细渲染、丰富细节、轻微柔焦)/ 情绪与潜台词(微表情,冻结在一个有戏的瞬间,拒绝僵硬摆拍)。
- 画面里需要准确文字(节目名、背景屏标语)时,把文字原文放在引号里,例:`背景屏上写着 "深夜电台"`。
- **角色图**:写清身份(年龄、体型、显著特征)、五官(眼型、下颌线、发型发色)、妆造、服装配饰(材质、版型、颜色、新旧),以及声音描述。
- **关键帧示例**:`过肩中近景,从主持人左肩后方拍向嘉宾。参考图2的退休宇航员,六十多岁,银白短发,深蓝针织开衫,坐在深色木桌右侧,面前一支黑色广播话筒,正微微前倾开口说话,眼角带笑纹,目光越过镜头看向主持人。台灯2700K暖光从左前方打在他脸上,右半边脸落入阴影;背景直播间的隔音墙虚化成深青蓝色。克制的青蓝调色,细腻胶片颗粒,脸部清晰锐利。`
- **视频提示词**:主要写「变化和动态」,不重复参考图里已有的静态细节。结构:运镜 + 说话人情绪 + 说话状态 + 具体肢体动作 + (可选)背景事件。动作要带程度副词(缓慢地、幅度很小地、频繁地),多个动作按先后顺序列出;如果人物不动也要明确写静止姿态。
- 说话镜头示例:`镜头缓慢推近。嘉宾带着怀念的神情开口说话,语速放慢,先低头笑了一下,然后右手在空中缓缓画出一道弧线,抬眼看向主持人;背景台灯的光微微摇曳。嘉宾说:"那一刻我才明白,地球是没有国界线的。"(温和、带一点哽咽)无音乐,无字幕。`
- 固定反向约束:单独有旁白音轨的镜头,视频提示词里不写旁白原文;几乎每条都写「无音乐」;永远写「无字幕」。
## 在 TVVV 上执行
- 角色三视图、场景布景图、每个镜头的关键帧都用 generate_image;关键帧的 reference_images 带上该镜相关的角色图和场景图,再加上前面镜头里最相近的一张关键帧(同一批里后面的镜头参考前面的),锁住站位、朝向和表情。
- 每个镜头 generate_video 用该镜关键帧作为 first_frame,同时把角色图作为 reference 带上(同一 图N)。说话镜头在提示词里写台词原文和语气,让视频带口型和对白一起生成;反应镜头写「不说话」,只做表情和小动作。
- 默认图片模型 Nano Banana 2;关键帧里有节目名、字幕条之类精确文字时用 GPT Image 2。默认视频模型 Seedance 2.5,aspect 16:9,单镜 5-10 秒,默认 720p。
- 旁白(开场介绍、结尾总结)用 generate_speech,写清声音身份和语气(例:沉稳的男声播音腔,语速中等偏慢)。每位说话人的声音描述全程固定,视频提示词里每次都复述一遍(例:主持人=30 岁女声,清亮柔和,语速中等)。
- 垫乐用 generate_music:轻柔的访谈垫乐(钢琴 + 轻电子底,约 80BPM),3 分钟以上且有明显段落时可分段。
- 一次回复最多 3-4 次工具调用:关键帧每批 3-4 张,视频每批 2-3 镜,回来检查口型和人物一致性再继续。
- 交付清单:按镜号列出视频;以对白为主轴,镜头之间的停顿收紧保持谈话节奏,节奏平了就插反应镜头;垫乐在人声下压低(约 -15dB),避开和人声打架的和弦;旁白按镜头范围摆放。提示用户去 TVVV 时间轴剪辑合成,字幕在剪辑时统一加。
## 注意事项
- **口型对不上**:脸太小或多人同时说话最容易出问题。说话镜头一律中近景以上、一镜只一人开口,你来我往就拆镜。
- **人物在镜头间变样**:每个关键帧都带角色图 + 前一张相近关键帧;同一角色换造型时用旧造型图做参考生成新造型。
- **声音音色漂移**:每位说话人的声音描述写死并在每镜复述;音色差异大的镜头单独重跑。
- **对话节奏拖沓**:AI 生成的说话镜头首尾常有空白,剪辑时裁紧;每 3-4 个说话镜头插一个反应镜头。
- **声音重复或错位**:旁白独立成轨时,视频里不要再生成同一段旁白;画面里不出配乐,垫乐统一后期加。