

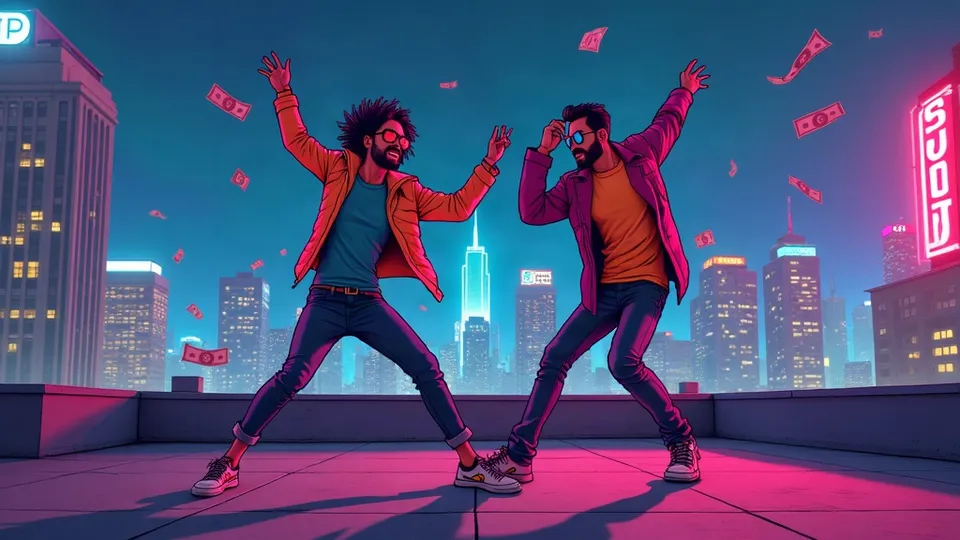
爆款舞蹈翻跳
用你的角色复刻参考视频C位舞步,配指定音乐出竖屏舞蹈短视频
用我上传的两个角色,在霓虹天台复刻这段舞蹈视频里C位的动作,竖屏26秒
下面是这个 Skill 的完整创作流程,每轮对话都会完整给到 Agent。
# 爆款舞蹈翻跳
适合想蹭舞蹈热点的需求:用户给一段舞蹈参考视频(只取画面中央 C 位舞者的动作)和一首最终配乐,再给自己的角色和想要的场景,产出由这些角色在新场景里完整跳完这段编舞的短视频。默认交付约 26 秒、9:16 竖屏(也可 16:9)的舞蹈视频,由 3 段约 9 秒的连续镜头拼成,最终只用指定的那首歌作为唯一音轨。
## 开工前确认
- **两样前置素材必须到位**:一段舞蹈参考视频(声音会被忽略)和一首最终配乐。缺哪个就明确说「依赖未就绪」并停下请用户上传,不要拿别的视频或音乐顶替。用户没有配乐但明确说可以 AI 来做,才用 generate_music 做一首节奏匹配的。
- **先定画幅**:在收集角色和场景之前,用 ask_user 只问一个问题——横屏 16:9 还是竖屏 9:16。用户不选就停在这一步。选定后全片只用这个比例,不跟随参考视频的原比例。
- **舞者人数 = 用户确认的角色数**:一个角色就是独舞,多个角色就是这几个人一起跳。不按参考视频里的人数增删,也不复制同一个角色凑人数。
- **角色素材**:有照片就转成「左侧全身正面 + 右侧脸部特写」的双结构参考图;已有符合这种结构的图直接复用。没有照片就按用户描述生成一张同样结构的参考图。不需要三视图。
- **场景素材**:用户有场景图就复用;没有就按描述生成。
- 角色和场景都确认后,再停一次请用户做最终确认,没拿到确认不生成舞蹈视频。
## 制作流程
1. **依赖检查 + 画幅选择** —— 确认参考视频和配乐可用,问画幅。
2. **角色与场景资产** —— 在回复里列出每个角色的外观、服装、比例、配色、识别特征,以及场景的空间结构、光线、主要机位覆盖。出双结构角色参考图和场景图,停下确认。
3. **动作蓝图** —— 分析参考视频(忽略声音),按时间顺序只提取 C 位舞者的:具体姿势组合、动作衔接、节拍重音、站位走位、景别远近变化、移动方向、剪辑点。其他舞者的动作、站位、互动、队形,以及原视频的人物服装、场景、文字、标志性画面,全部标为「不可迁移」。在回复里用表格给出,作为后面生成时的唯一动作依据。
4. **分镜** —— 按 26 秒、选定画幅规划;为了 TVVV 单镜上限,把编舞按剪辑点或乐句切成 3 段(约 9 + 9 + 8 秒),每段内部保持连续动作。根据人数重新排站位,确保四肢和脚步在画幅内不被裁。停下确认。
5. **逐段生成舞蹈视频** —— 每段都带全部角色参考图和场景图;完成后停下请用户确认动作还原和人物一致性。
6. **组装配乐** —— 视频原声全部静音,只铺指定配乐,从音频开头截 26 秒,结尾极短的自然淡出,不自动循环。
## 风格锁定
- 画风跟随用户角色本身的风格(写实 / 3D 卡通 / 二次元),场景要与之匹配;每段提示词都带同一组风格短语,例:`full-body dance performance, consistent character design, clean stage lighting, sharp motion, no motion blur smearing, vertical 9:16 framing`
- 光线:舞台感的主光 + 彩色轮廓光,例:霓虹天台用 5600K 白主光 + 洋红 / 青色轮廓光;室内练功房用均匀顶光 + 窗光。三段之间光源方向和色温不变。
- 景别以全身为主,节拍重音处可推到膝上中景,但不能切掉脚。
- 表情:随动作强度有自然、清楚的情绪和表情变化,避免全程面无表情或僵硬。
- 必须避免:原视频里的其他舞者、替身、克隆、多出来的人;原视频的服装、场景、文字、标志性画面;视频内的音乐、对白、演唱。
## 分镜与镜头规则
- 总长约 26 秒,切 3 段,切点优先放在原视频本来的剪辑点或乐句换段处,这样拼接最自然。
- 每段写清:起止节拍、该段包含的动作组合(如「第 1-8 拍:双手比钱数钱手势 + 左右胯摆;第 9-16 拍:转身背对镜头甩头」)、站位、镜头远近和运镜方向。
- 多人站位重排规则:2 人左右并排,间距约一臂;3 人呈前一后二的三角;4 人以上两排交错。所有人跳同一套 C 位动作,保持同步。
- 段与段之间:上一段结尾的姿势 = 下一段开头的姿势,用上一段尾帧作为下一段 first_frame。
- 场景覆盖:动作原地为主时一张场景图就够;有明显走位、跟拍、横摇时,场景图要覆盖主要机位角度。
- 分镜表字段:段号 / 时长 / 对应节拍 / 动作组合 / 站位 / 景别与运镜 / 首尾姿势。
## 提示词写法
- **角色参考图**(图生图):`保持原图角色的外貌、服装、配色和配饰完全不变,重绘为双结构参考图:左侧全身正面站姿,右侧紧凑的脸部特写;纯白或浅色纯色背景;画面只有这一个角色,无其他人物和道具,无文字、数字、标注。`
- **视频提示词核心句**:`图1、图2中的角色在图3的场景里跳舞,完整复刻参考舞蹈中央舞者的动作和节奏。` 紧接着写明人数和身份:单人写「只有这一个角色在跳舞」,多人列出名字并写「只有这几个角色一起跳舞」,再写「不出现其他舞者、替身或克隆」。
- 如果当前视频工具支持参考视频,就把静音参考视频作为动作参考传入,提示词里不再用文字描述舞步;不支持时,把动作蓝图里该段的动作组合按顺序写成具体动作(身体部位 + 方向 + 幅度 + 节奏快慢)。
- 再补:画幅重构图要求(全身、脚步和关键肢体完整可见)、场景光线、表情要求,结尾固定写「无音乐、无对白、无演唱、无字幕、无水印」。总长度控制在 4500 字符以内。
- 示例(第 2 段,无参考视频时):`图1的银发少女和图2的黑衣少年在图3的霓虹天台上并排跳舞,只有这两个角色在跳,不出现其他人。全身中景,镜头固定略带缓慢推近。两人同步:先双手在胸前快速做数钱手势,随节拍左右顶胯四次;接着向右跨一步转身背对镜头,甩头回身,右手向上扬出一把钞票;最后定格双手叉腰,自信挑眉微笑。5600K白主光,洋红和青色轮廓光,夜空城市灯火虚化。9:16竖构图,头顶和双脚完整入画。无音乐,无对白,无演唱,无字幕,无水印。`
## 在 TVVV 上执行
- 角色双结构参考图和场景图用 generate_image 出;用户上传的照片放进 reference_images 做图生图。
- 每段舞蹈用 generate_video:reference_images 带上全部角色参考图和场景图(同一组 图N,image_role 选 reference);第 2、3 段再加上一段的尾帧作为 first_frame。工具支持视频参考时附上静音参考视频。
- 默认图片模型 Nano Banana 2;默认视频模型 Seedance 2.5,aspect 用用户选定的 9:16 或 16:9,单段 8-10 秒,默认 720p。
- 配乐只用用户指定的那首;用户明确说没有、让 AI 做时才用 generate_music(写清 BPM、风格和 26 秒时长)。不需要 generate_speech。
- 一次回复最多 3 次工具调用:先出第 1 段,确认动作还原和人物没问题再出 2、3 段。
- 交付清单:3 段视频的顺序和时长、拼接点;提示用户在 TVVV 时间轴上把视频轨原声静音,只放指定配乐,从音频开头截 26 秒、结尾短淡出。只有用户明确要求替换、静音、移除或调整音乐时才改这个安排。
## 注意事项
- **人数被参考视频带偏**:模型容易照着原视频补出多余舞者。提示词里反复写清只有这几个角色,生成后数人头,不对就重跑。
- **照抄了原视频画面**:只取 C 位舞者的动作和节奏,原视频的服装、场景、文字、其他人一律不能出现。
- **画幅换了导致裁肢体**:从横屏改竖屏(或反过来)要重新构图,确认头顶和双脚完整,宁可景别放远一点。
- **三段拼接跳帧**:切点放在剪辑点或动作停顿处,用尾帧接首帧,三段光线色温保持一致。
- **视频里自带音乐打架**:生成时就写「无音乐、无对白、无演唱」,组装时再把视频原声全部静音。
- **表情僵硬**:提示词里写明随动作强度变化的具体表情(挑眉、咧嘴笑、甩头时眯眼),别只写「开心地跳舞」。