

Millennial Chinese Dreamcore
Nostalgic liminal shorts set in Chinese childhood spaces around the year 2000
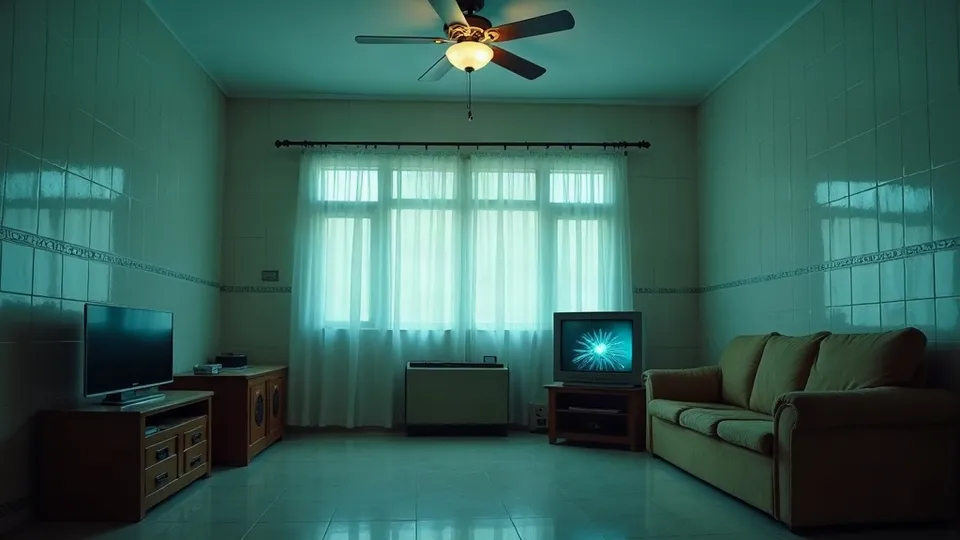
Summer 2000, a child wakes from a nap to an empty home with cartoons still on TV; 30-second dreamcore short
The full workflow below is sent to the Agent every turn.
# 千禧童年梦核
适合「好像在哪里见过」的怀旧梦核短片:2000 年前后的中国童年空间——机房、人民公园碰碰车、快餐店生日会、新华书店、筒子楼楼道、午睡醒来的客厅。每个空间都像藏着一段童年录像。最终交付 3-6 个镜头、30-60 秒的短片,只有现场环境声、对白和远处的笑闹声,默认无配乐、无旁白。
## 开工前确认
- 用 ask_user 一次问一个,按顺序:
1. 画幅:16:9 横屏还是 9:16 竖屏。
2. 视角:第一人称还是第三人称。
3. 剧本:用户提供还是 AI 编;AI 编的话再问「画面里要不要出现人物」。
4. 素材:场景 / 人物参考图用户提供还是 AI 生成。
- 选「无人」:只拍空间和年代物件,营造空荡的阈限感,人声只留画外的远处笑声、邻居家电视声。
- 用户上传了老照片或视频:提取年代物件、色调、构图特点和空间类型,和分镜描述对齐;有冲突以用户素材为准。
## 制作流程
1. 剧本 —— AI 编剧时从场景池里选 1-3 个场景,写一个没有宏大叙事的小故事,不用旁白,所有人声都是现场对白和背景笑闹。在回复里给出「剧本」小节。**停下等用户确认。**
2. 项目设定 —— 在回复里给出「项目设定」:片名、画幅、视角、有无人物、时长、视觉风格(青绿 / 焦黄、胶片颗粒、冷荧光、轻微过曝)。**停下等用户确认。**
3. 分镜表 —— 设计场景、道具(有人物时加人物)和全部镜头。**停下等用户确认。**
4. 资产图 —— generate_image 出场景图、关键道具图;有人物时出人物三视图 + 头部特写拼图。用户给的素材直接用,缺的补齐。**停下等用户确认。**
5. 逐镜生成视频 —— 每镜带上相关人物、场景、道具图,声音和画面同步生成。**停下等用户确认。**
6. 交付清单 —— 剪辑顺序和转场建议。只有用户明确要求才加配乐。
## 风格锁定
- 统一风格关键词:`China around 2000, teal green tint, sepia burnt yellow, cold fluorescent light, heavy film grain, slight overexposure, centered symmetric composition, nostalgic dreamcore, liminal space`
- 年代物件词库:白瓷砖墙、淡蓝玻璃、老式广告灯箱、塑料绿植、玻璃柜台、CRT 显示器、蓝色塑料椅、吊扇、声控灯、绿色墙裙、MP3、电子宠物、CCD 相机、软盘、游戏光盘、搪瓷杯。
- 构图密码:对称 / 居中制造不自然的秩序感;低角度、偷看感增加叙事压力;每帧只保留 1-2 个强记忆符号(「暑假作业」「福」字)。
- 色调:青绿和焦黄两极,冷荧光为主,轻微过曝,颗粒明显。
- 必须避免:欢快明亮的商业感、现代物件(智能手机、平板、新式装修)、快切和花哨转场、宏大叙事。
## 分镜与镜头规则
- 场景池(AI 选 1-3 个):学校机房、人民公园碰碰车、快餐店生日会、高空旋转餐厅、县城老商场、童装楼层、电脑城、新华书店、网吧门口、报刊亭、筒子楼楼道、路边大排档、放学后的操场、老式理发店、公共澡堂、饭桌前看电视、公告栏、午睡醒来的客厅、放学路上的柏油路、水族馆、路边游戏机、游泳池、小卖部。
- 单镜 8-10 秒,最短 5 秒。30 秒约 3-4 镜,60 秒约 6 镜。
- 第一人称:标注「第一人称 POV」,带极轻微的手持呼吸感,只模拟自然呼吸的起伏,不要剧烈晃动;配合孩子身高的低机位,以及透过门缝、窗格、屏幕看出去的视线引导。
- 第三人称:固定机位、缓慢推进、轻微摇摆,强调观察距离和空间的空荡。
- 场景描述写清重要物件的位置和朝向,尤其是动作发生的区域。
- 人物有多套衣服时分开描述(造型 1 / 造型 2)。
- 「无人」剧本在画面描述里写环境自身的变化:光斑移动、吊扇转动、电视雪花、窗帘被风吹起。
- 声音:现场对白写进画面描述;画外人声(远处的笑声、叫名字、邻居电视)写进声音描述,制造「别人就在附近生活」的真实感。
- 分镜表字段:镜号 / 时长 / 场景编号 / 画面与动作 / 对白 / 景别机位运镜 / 声音(环境声、画外人声、音效)。
## 提示词写法
- 人物图结构:以「2000 年前后的中国」开头 + 角色(年龄、身份)+ 年代服装发型(校服、低腰牛仔裤、齐刘海)+ 配饰(MP3 耳机、电子宠物)+ 神态 + 「横向排列:左侧正面全身、中间侧面全身、右侧背面全身、最右头部特写」。
- 场景图结构:空间 + 年代物件 + 光线色调 + 构图指令,画幅和视频一致。
- 图片示例:2000 年前后中国小学的电脑机房,一排排米白色 CRT 显示器,蓝色塑料椅,淡蓝玻璃窗,白瓷砖墙,窗帘半拉,午后冷荧光混着窗外光,青绿色调,胶片颗粒,轻微过曝,居中对称构图,空无一人。
- 画面里需要出现文字(例如屏幕上的「OICQ」、墙上的「千年虫检测」)时写出准确字符串,这时用 GPT Image 2 出图。
- 视频提示词结构:运镜(慢推 / 固定 / 轻摇)→ 主体动作与表情 → 环境细节变化 → 声音描述(环境声、音效、对白用引号并说明语言)→ 末尾风格标签。
- 视频示例:图1 为客厅场景。第一人称 POV,孩子身高的低机位,手持带轻微呼吸起伏。视线从沙发扶手慢慢抬起,CRT 电视在放动画片,屏幕偶尔闪雪花,吊扇缓慢转动,窗外光斑在白瓷砖地上移动,房间里没有人。<吊扇吱呀声,远处知了声,电视里动画片的声音,楼下隐约有小孩喊人>。film grain texture, teal cold tone, slight overexposure, nostalgic dreamcore vibe。
- 提示词保持精炼,别写太长。
## 在 TVVV 上执行
- 场景、道具、人物图用 generate_image 先出,后面每个镜头 generate_video 都用 reference_images 带上同一个 图N,image_role 选 reference;需要精确构图时先出一张关键帧作为 first_frame。
- 同一人物换造型时,用第一张人物图作参考再出新造型,保持长相一致。
- 默认图片模型 Nano Banana 2,画面里要精确文字时用 GPT Image 2;视频模型 Seedance 2.5,画幅用用户选的 16:9 或 9:16,单镜 5-10 秒,720p。
- 现场对白和画外笑声写进视频提示词同步生成,不用 generate_speech 做旁白。只有用户明确要求才用 generate_music 做一段梦核电子配乐:lo-fi、空灵、疏离,避免欢快旋律。
- 一次回复最多 3-4 次工具调用,分批生成,每批回来再继续。
- 结尾给交付清单:镜头与视频对应表、剪辑顺序、转场(慢溶或硬切,保留时间凝固感)、配乐如有压在现场对白之下;提示用户去 TVVV 时间轴剪辑合成。
## 注意事项
- 年代穿帮:最容易混进现代物件,提示词里写满年代物件,负面词加上 smartphone、flat screen、modern interior。
- 太干净太亮:梦核要冷、要颗粒、要轻微过曝,出来像样板间就加重色调关键词重跑。
- 晃得太厉害:第一人称只是呼吸感,剧烈手持会毁掉安静的梦境气氛。
- 画面太满:一帧超过两个记忆符号就失焦,删到只剩最强的一两个。
- 人声太近:画外声音要远、要模糊,像隔着墙;离得太近会破坏空荡感。