

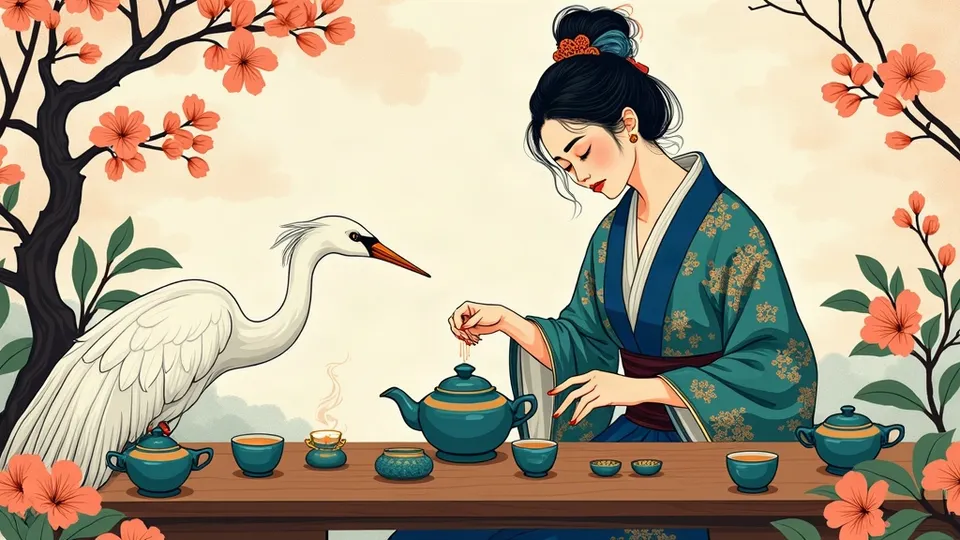
丝巾插画质感广告片
细线描、高密度纹样、宝石色点缀,做像奢侈品丝巾画面一样的TVC插画短片
做一支中式庭院茶会主题的丝巾插画风广告片,有仕女、白鹤和园林,约20秒
下面是这个 Skill 的完整创作流程,每轮对话都会完整给到 Agent。
# 丝巾插画质感广告片
适合品牌广告、节日短片、文化主题宣传:每一帧都像一条可以直接丝网印在真丝上的方巾图案,细而均匀的黑色描线、平涂色块、布料和地毯上铺满纹样,象牙白底配冷暖平衡的宝石色。交付一支 15-30 秒的 16:9 横屏插画短片:3-5 个场景,每个场景固定「远景建立 + 近景跟拍」两个镜头,每镜约 3 秒,只有贴合动作的精致音效,没有配乐、旁白和对白。
## 开工前确认
- 先确认主题和叙事场景,例如:中式庭院茶会、欧洲宫廷晚宴、巴黎公寓的一天、马术与骏马、海上航行。用户只说品牌或产品时,提 2-3 个适合的主题让他选(ask_user 一次只问这一个)。
- 可选素材:风格参考图(会分析线条密度、描边粗细、上色方式、纹样密度、主色与点缀色)、角色或动物参考、产品图。
- 要确认的只有:主题、大约时长(15 / 20 / 30 秒)、要不要出现产品。其他按默认来。
## 制作流程
1. **项目设定** —— 在回复里用表格列:主题、画幅 16:9、时长、场景数、视觉风格、是否出现产品。**停下来**确认。
2. **分镜表** —— 列出所有角色、动物、场景,每个场景写 A 远景 + B 近景两个镜头,标出哪几镜有音效。**停下来**确认。
3. **元素图** —— 每个角色 / 动物出左右双格参考图(左边脸部、发型、领口特写;右边全身服装、配色、姿态),每个场景出一张完整的前中后景全景图。**停下来**确认。
4. **逐场景生成视频** —— 每个场景一组:先 A 远景,再 B 近景,带上对应元素图。
5. **音效** —— 只在分镜里标了音效的镜头做,写进视频提示词同步生成。
6. **交付清单** —— 剪辑顺序、每镜裁剪长度、音效对齐点。
## 风格锁定
- 统一风格关键词(每条提示词都带):`luxury silk scarf illustration, ligne claire with uniform fine black outlines, hard straight lines for architecture and organic curves for figures and plants, flat color blocks with high-density pattern infills on fabrics carpets and murals, balanced jewel palette of royal blue emerald deep purple against ochre gold vermilion burgundy, ivory or sand base, soft even lighting, no strong shadows or highlights, matte silk texture, dense narrative decorative composition, screen-printable graphic art`。
- 线条:细而均匀的黑色描线,轮廓全部闭合、干净无毛刺,不是粗细变化的水墨笔触。
- 色彩:象牙白、米白或沙色做底;冷色(宝蓝、普鲁士蓝、祖母绿、深紫)和暖色(赭金、朱红、酒红、橙红)平衡出现,中等饱和度,别让金色一家独大。
- 填色:主体平涂;布料、地毯、挂毯、建筑彩绘必须铺满高密度纹样(几何纹、卷草纹、花鸟纹),每一寸都有可看的装饰信息。体积感只用细点或颗粒,不用渐变和重阴影。
- 构图:每一帧都像一条完整的丝巾 —— 前景植物或器物、中景人物或动物、背景建筑或山水,文化符号和自然意象密集。
- 必须避免:写实渲染、3D 质感、强阴影和高光反射、随手抓拍感、画面杂乱、文字和 logo(除非品牌明确要求)。
## 分镜与镜头规则
- 每个场景固定两镜,顺序不变:
- **A 远景建立**:前中后景层次完整,主体在中景、比例适中;慢慢横摇或轻微推近,一个克制的动作;主体基本静止或只有衣袂飘动、鸟羽轻扇。
- **B 近景跟拍**:拍人物或动物上半身,突出一个具体动作(倒茶、举杯、翻书、鸟落枝头);镜头顺着动作方向慢慢跟,带一点弧形环绕感。
- 每镜默认约 3 秒,只有动作在 3 秒内做不完时才放到 4-5 秒。一个镜头只放一个动作,不要叠动作。
- 动作写准确的动词和身体细节,例如「右手慢慢提起茶壶,手腕微转,一线细茶注入青瓷杯,动作舒缓优雅」。
- 节奏:场景之间全部硬切,不用叠化和黑场,靠镜内动作和构图变化推进。
- 3-5 个场景 × 2 镜 = 6-10 个镜头,剪完 18-30 秒。
- 音效只选细腻、贴近的质感声:丝绸摩擦、皮革轻响、器物相碰、倒茶声、翅膀扑动、微风。
- 分镜表字段:场景 / 镜头(A 或 B)/ 剪辑时长 / 画面与动作 / 运镜方向 / 音效(有或无)。
## 提示词写法
- 提示词用中文写,风格关键词保留英文。只写镜头里看得见的东西。
- **元素图结构**:主体(人物写服装的朝代或文化背景、发型、配色;动物写品种、毛色、姿态)→ 场景层次 → 风格关键词 → 构图说明(角色图写「左右双格,左边近景特写,右边全身」)。
- 图片示例:
```
唐代仕女,高髻插金步摇,身穿宝蓝底金色卷草纹宽袖襦裙,系青玉腰带,手执团扇。左右双格参考图:左格为脸部、发髻与领口特写,右格为全身站姿,衣料上铺满细密的缠枝花纹。象牙白底。luxury silk scarf illustration, ligne claire with uniform fine black outlines, flat color blocks with high-density pattern infills, balanced jewel palette of royal blue, emerald and ochre gold, soft even lighting, matte silk texture.
```
- **A 远景视频结构**:图N 分别是场景和主体 → 运镜(方向 + 速度,3 秒内一个动作)→ 主体轻微动态 → 风格关键词 → 负面词。
- **B 近景视频结构**:图N 分别是主体和场景 → 跟拍方向(左 / 右 / 前)和弧度 → 精确动作(动词 + 身体部位 + 节奏)→ 音效(用尖括号写,如〈倒茶声,轻柔〉)→ 风格关键词 → 负面词。
- 视频示例(B 近景):
```
图1 是唐代仕女,图2 是庭院茶席。近景跟拍,镜头随她的手从左向右缓缓移动,带轻微弧形环绕。仕女右手慢慢提起青瓷茶壶,手腕微转,一线细茶注入白瓷杯,宽袖上的卷草纹随动作轻轻起伏,身后屏风上的白鹤纹样清晰可见。〈倒茶声,轻柔贴近〉〈丝绸袖口轻微摩擦声〉。luxury silk scarf illustration, ligne claire uniform fine outlines, flat color with dense pattern infills, jewel palette, ivory base, soft even light, matte silk texture。无字幕,无文字叠加,无对白,无旁白,无音乐。
```
## 在 TVVV 上执行
- 元素图用 generate_image,默认 Nano Banana 2,resolution 2K 或 4K;角色双格图和场景图都用 16:9。用户上传了风格参考图时放进 reference_images 学线条和配色。需要在画面里写品牌名或标语的收尾帧,用 GPT Image 2。
- 视频用 generate_video,默认 Seedance 2.5、720p、16:9,image_role 用 reference,每镜都带场景图 + 主体图;B 近景想和 A 远景空间完全一致时,可以把 A 镜的末帧截图作为 first_frame。
- 每镜生成 5 秒(模型时长下限),剪辑时从中挑动作最完整的约 3 秒。
- 有音效的镜头把音效写进提示词同步生成;没标音效的镜头把 generate_audio 关掉,保持安静。不用 generate_music 和 generate_speech。
- 一次回复最多 4 次工具调用:一轮做 1-2 个场景(每场景 A + B 两镜)。
- 交付清单:按「场景1A → 场景1B → 场景2A → …」列出视频、每镜裁到的时长、全程硬切、音效对齐到动作触发点(倒茶落杯、翅膀张开那一下)、没有音效的地方保持安静不垫音乐。提示在 TVVV 时间轴拼接,品牌 logo 可在最后一镜后加 2 秒定版。
## 注意事项
- **变成写实画风**:模型一动起来就爱加光影和体积,提示词里必须重复 flat color、no strong shadows、soft even lighting。
- **纹样糊掉**:纹样密度靠元素图打底,元素图不够密时先重出图,不要指望视频补细节。
- **金色太多**:在风格词里点名冷色(宝蓝、祖母绿、深紫),并检查每张图冷暖是否平衡。
- **动作太大**:远景镜头的主体几乎不动,近景镜头只做一个动作;大幅度动作会让线条抖动、纹样闪烁。
- **出现文字乱码**:负面词带 no text overlay;真正要文字的定版帧单独用 GPT Image 2 出图。