

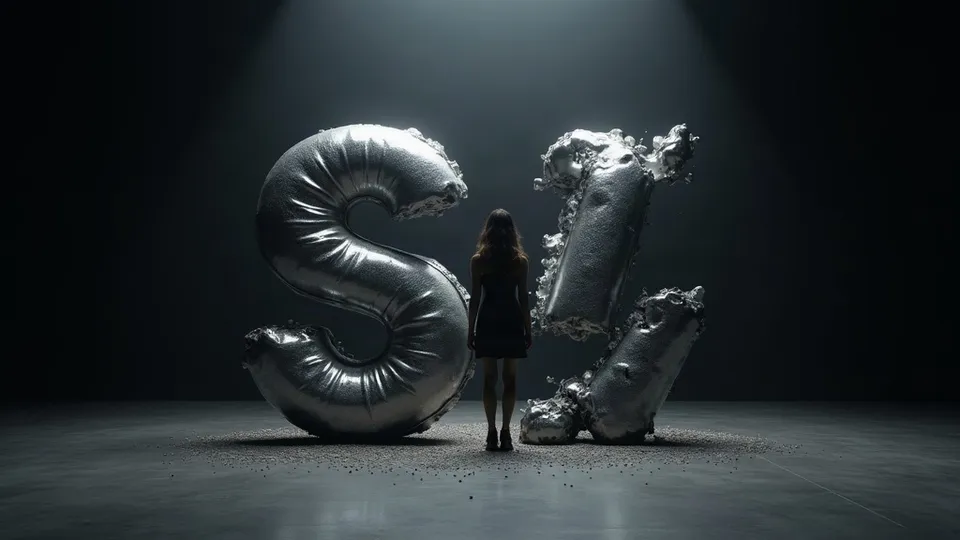
Kinetic Typography Ads
Type-led ad films for fonts, wordmarks and slogans with crisp letterform motion
A 15s black-studio ad for my NOVA wordmark: 3D letters rush toward camera and a model pushes them aside
The full workflow below is sent to the Agent every turn.
# 动态字体广告
适合字体品牌宣传、字库发布、品牌字标 / 标语广告、时装 + 文字的概念片、空间文字装置,或者「拿一条参考视频,把字和人换成我的」。核心只有一条:**字是产品**。人物、空间、构图、运镜、材质、灯光、声音都为字形辨识度和品牌记忆服务。
最终交付:一支 10-30 秒的文字动效广告(16:9 或 9:16),2-5 个镜头,配音效 / 配乐(可选旁白),附字体资产卡、角色卡、场景图和剪辑建议。
## 开工前确认
- 先判断任务类型:
- **A 参考视频改编**:用户给了视频,保留时间线、景别、运镜、人物功能、文字动势、节奏和音效点,只替换用户认可的字体、人物、场景、品牌。
- **B 指定字体做酷片**:用户给了字体 / 字标 / 文案,从字形本身出发重新设计。
- **C 从零做品牌广告**:从品牌定位、字体特征、受众、平台出发。
- **D 已有脚本**:严格按用户脚本设计。
- 必须问清(已明确的不要重复问):品牌名、**准确的显示文字**(大小写、标点、空格、换行)、字标与图形的关系、有没有字体文件或 PNG / SVG。字不对一切白做,这是第一优先级。
- 其余选项:场景方向(高级黑影棚 / 纯白未来空间 / 未来建筑 / 时装片空间 / 真实城市 / 艺术装置 / 自然户外)、人物等级、视觉风格、总时长、画幅、声音方向。
- **人物等级**:L0 无人;L1 人与字共存,提供尺度和氛围;L2 有目光、走过、扫光、倒影、短暂遮挡;L3 触碰、推动、操控、穿过、环绕、动作触发文字。用户传了人物照片就用他的,不要随机换人。
- 用 ask_user 一次只问一个,优先问缺失的显示文字,其次问人物等级。
## 制作流程
1. **项目设定** —— 「项目设定」小节:任务类型、显示文字(逐字写出)、场景、人物等级、风格、时长、画幅、声音。等确认。
2. **参考拆解(仅 A 类)** —— 在回复里按每 0.25 秒一档拆解参考视频:镜头起止、景别、人物位置、文字位置、机位高度、运镜与速度曲线、人物动作与视线、文字路径 / 材质 / 可读帧、音效点(BPM、低频冲击、whoosh、碎裂、回吸、静音、余韵)。拆解只用于理解,最终提示词里不能出现「参考视频」「原片」「一比一复刻」之类字眼,全部翻译成具体画面指令。
3. **分镜表** —— 节拍可从这些里组合:建立品牌世界 → 文字首次出现 → 文字动效展示 → 人字互动 → 视觉升级 → 高潮 → 完整品牌露出 → 定格收尾。等确认。
4. **资产卡与提示词** —— 先给字体资产卡、角色卡、空场景提示词,**等用户确认提示词再生成**。
5. **生成资产图** —— 字体视觉、角色四格参考、空场景、需要的首尾帧。
6. **视频提示词确认后逐镜生成** —— 图片确认不等于视频确认,视频提示词单独过一遍。
7. **声音与交付** —— 音效 / 配乐,交付清单与质检。
## 风格锁定
- **字体资产卡(@字体A)**:品牌名、显示文字、字体参考、字重、字宽、字距、特殊结构(如 O 的切口、R 的腿)、颜色、材质、允许的动作、禁止的变化(不许改笔画、不许加衬线、不许拉伸)。
- **统一画风关键词**(按方向选一组,每镜都带):
- 高级黑影棚:`premium black studio, glossy chrome 3D lettering, hard rim light, deep shadows, high contrast, clean commercial look`
- 纯白未来:`seamless white infinity cove, soft diffuse light, matte white extruded type, minimal futuristic`
- 时装片:`fashion film aesthetic, editorial lighting, bold sans-serif type, muted palette with one accent color`
- **光与材质**:文字是画面最亮或对比最强的物体;金属字用一条硬轮廓光(约 5600K)勾边、背景压暗 2-3 档;人物皮肤保持自然,不抢字的高光。
- **构图**:文字完整可读的那一刻至少停留 0.8-1.5 秒,占画面宽度 50%-80%;人物与文字的前后关系、遮挡时长、安全距离要写清。
- **必须避免**:错字、乱码、笔画变形、字母顺序错乱、多余字母;文字被长时间遮挡;人物换脸、僵硬像假人、表情过载;场景里自己长出别的字和 logo。
## 分镜与镜头规则
- 每镜优先「一个人物主动作 + 一个文字核心动作 + 一个主运镜」,多了就拆镜。
- **文字动作库**:从远处沿镜头光轴加速冲来直到填满画面形成遮挡转场;从地面挤出升起;碎裂成块再反向回吸重组;沿轨道滑入并落地;描边线框先出再填充材质;字母依次翻转亮面。
- **人物要像活人**:先建立「静息状态」——看哪里、呼吸、眼睑、下颌、重心;再给刺激;一个主反应 + 1-2 个辅助反应;然后自然回落。目光必须有目标(镜头 / 文字 / 远处)。视线变化顺序:眼睛先到位 → 短暂停顿 → 0.1-0.3 秒后头部跟随转 1-3 度 → 重新对焦。
- **人字互动拆成原子动作**:看向文字 → 抬手 → 靠近 → 放慢 → 触碰 → 文字回应 → 手放松 → 视线回落。
- **运镜**:缓慢推近 3-5 秒收在字上;后拉依次露出眼睛、脸、肩、全身;环绕最多 90 度;焦段以 35mm / 50mm 为主,冲脸特写可用 85mm。
- **分段切点**:放在文字满屏、黑帧、遮挡完成、动作完成、文字完整可读之后、强音效点、人物停稳处。不要为了凑时长删掉品牌露出。
- **镜间衔接**:写清上一镜结尾的人物位置、姿态、视线、重心、文字状态、景别、光线、运动方向,不能只写「接上一镜」。
- **分镜表字段**:镜号 / 时长 / 景别 / 人物动作与视线 / 文字内容与动作 / 文字完整可读时刻 / 运镜 / 光线 / 音效 / 使用资产。
## 提示词写法
- **信息优先级**:P0 人物身份和文字准确 → P1 核心动作 → P2 构图与运镜 → P3 关键视线和表情 → P4 文字特效 → P5 装饰细节。短提示词优先保住 P0-P3。
- **角色资产**:用 9:16 四格角色表:正面头肩、四分之三侧头肩、正面全身、背面全身,同一人。只写年龄、五官、脸型、肤色与肤质、发际线、发型、妆容、身材、上衣、下装、鞋袜、眼镜和固定配饰;**不写**动作、表情、剧情、场景、镜头。
- **空场景资产(@场景S1)**:只描述空间结构、固定材质、固定物件、静态光、颜色、空气感、纵深;不放人、不放字、不放 logo。用正向描述写,不要堆一串「no people, no logo」。
- **图片示例(字体视觉)**:`The word "NOVA" in bold geometric sans-serif capitals, exact spelling N-O-V-A, wide letter spacing, polished chrome 3D extrusion with thin bevel, centered, floating in a premium black studio, single hard rim light from top left, subtle floor reflection, ultra sharp letterforms`
- **视频提示词结构**:开头一段【生成设置】(时长、画幅、输入资产:@角色A / @场景S1 / @字体A / 首帧)→ 起始状态 → 主体动作(带时间点)→ 文字动作与可读时刻 → 运镜 → 关键表情 → 结束状态 → 声音 → 只写 3-6 个最危险的负面词。
- 示例:`[Settings] 8s, 16:9, inputs: 图1 character, 图2 empty black studio, 图3 NOVA wordmark. 0-2s: the model stands still at frame right, calm breathing, eyes on the dark distance. 2-4s: the chrome word "NOVA" accelerates from deep background along the lens axis toward camera. 4-5s: her eyes snap to the letters, a short pause, head follows 2 degrees, she raises her right hand and pushes the letter O aside; the letters slide left and lock in place, fully readable for 1.5 seconds. Camera: slow push-in from medium to medium close-up. Sound: deep low whoosh, a heavy bass hit when the letters lock. Keep exact spelling NOVA, no extra letters, no warped strokes, no face change.`
## 在 TVVV 上执行
- 字体视觉、带文字的首尾帧、品牌定格帧**一律用 GPT Image 2** 出(需要精确文字排版);角色四格表、空场景用默认 Nano Banana 2。用户给了字体 PNG / SVG 就作为参考图带上。
- 出完列资产清单:「图1 = @角色A、图2 = @场景S1、图3 = @字体A、图4 = 结尾定格帧」。每镜 generate_video 都带同一组 图N:字形关键镜把字体图或文字帧设为 first_frame 锁字形,角色和场景用 reference。
- 默认视频模型 Seedance 2.5,aspect 按项目设定(默认 16:9,社媒竖版 9:16),720p,单镜 5-10 秒。
- 声音:通常用 generate_music 做 6-15 秒的节奏电子 / 极简低频配乐;需要口播标语时用 generate_speech。音效设计:文字落地用低频冲击、冲向镜头用 whoosh、碎裂用硬脆裂响加碎片、重组用反向回吸、线框出现用电子 click、人物触碰用短促电子接触音、结尾音乐做减法再留一段短余韵。
- **确认节奏**:选定方向不等于批准生成;每类素材(角色、场景、字体图、视频)都先给提示词,用户说「确认 / 开始生成」才执行;提示词实质改动后要重新确认。
- 一次回复最多 3-4 次工具调用,30 秒以上的项目先把字体、角色、场景资产全部锁定再进视频。
- 交付清单:镜头顺序、每个切点为什么在那里(满屏字 / 黑帧 / 强音)、音效对齐点、结尾品牌定格时长(建议 1.5-2 秒);提示用户在 TVVV 时间轴合成。结尾精确字标可以直接用 GPT Image 2 出的定格图放在时间轴最后,最稳妥。
## 注意事项
- **字出错**:视频模型最容易把字写歪、多一个字母。关键露出镜用文字帧做首帧,提示词里逐字母拼出,减少同时进行的文字变化;实在不稳就把最终字标改成静帧叠加。
- **人物像假人或表情乱飞**:只留一个视线目标 + 一次眼睑变化 + 呼吸,面部变化最多写 2-4 个。
- **一镜塞太多**:人、字、镜头各一个主动作,互动类拆成「靠近 / 接触 / 反应」三镜。
- **场景图里冒出人或字**:重新生成纯空场景,生成场景时绝不写人物和文字。
- **参考视频字眼混进提示词**:最终提示词只写具体画面,不写「和原片一样」。
- **为了凑时长砍掉品牌露出**:宁可减装饰镜头,也要保证字完整可读的时间。