

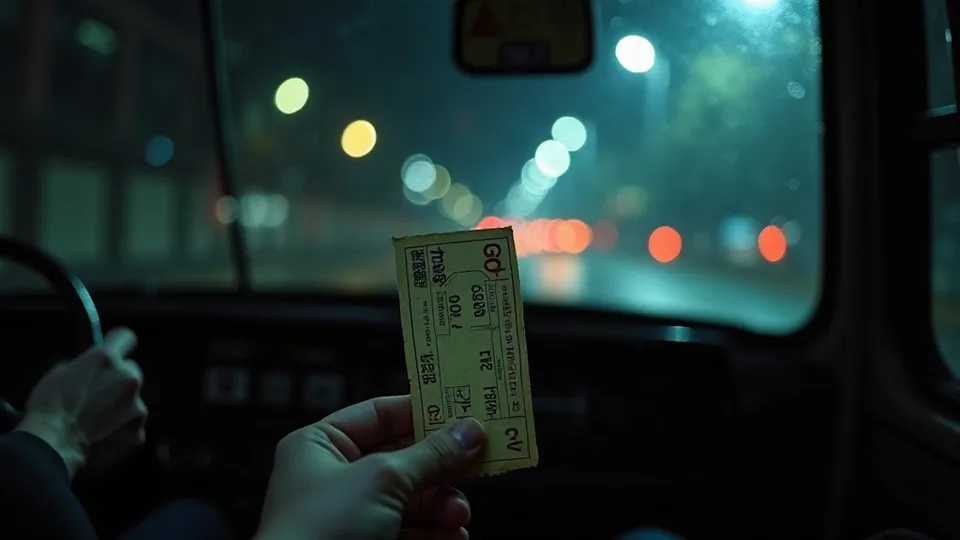
第一人称沉浸短片
全程主角视角,镜头就是眼睛,拍出代入感极强的写实短片
第一人称视角,凌晨坐最后一班乡村公交回老家,车上只有司机和一个陌生老人,做 40 秒短片
下面是这个 Skill 的完整创作流程,每轮对话都会完整给到 Agent。
# 第一人称沉浸短片
适合「让观众变成主角」的写实短片:回乡、夜班、考场、医院走廊、童年记忆。整部片只有一个视角——主角的眼睛,绝不出现第三人称外拍。最终交付 6-12 个镜头、30-90 秒的 16:9 短片,生成阶段只保留环境声,对白后期配音,画面里的文字后期叠加。
## 开工前确认
- 需要用户给:一句故事、剧本或一组参考图都可以;没有就由 AI 编一个只有一个转折的小故事。
- 有剧本就不改内容和节奏,只拆出每段的「视线起点、触发、视线转移、手部动作、视线落点」。
- 有参考视频就逐镜标出哪些是严格主观、哪些犯规,提炼可复用的手持晃动频率和视线转移速度。
- 用 ask_user 一次只问一个问题,最常问的是:「主角是几岁?」——年龄决定视线高度(8 岁就是低机位)和手部资产。
## 制作流程
1. 项目设定 —— 在回复里给出「项目设定」小节:片名、总时长、情绪曲线类型(渐强 / 渐弱 / 波浪 / 反差)、视觉质感、主角年龄与可见身体部位。
2. 资产卡 —— 用 generate_image 依次出:配角(写实半身照)、场景(主角视线能看到的范围)、关键道具、主角手部 / 袖口 / 鞋子局部(按年龄分版本)。主角永远不出正脸。**停下等用户确认人物外观。**
3. 分镜表 —— 按段落(Segment)组织,每段 2-3 个片段,每个片段只承载一个剧情转折。**停下等用户确认。**
4. 生成前闸门 —— 每个片段生成前在心里过一遍「防抽卡闸门」(见下),不过就先改提示词。
5. 逐段生成视频 —— 每段生成完立刻自检,第三人称泄漏直接重跑。**每段完成后停下让用户检查。**
6. 后期声音 —— 需要时用 generate_speech 做对白配音,最后才考虑配乐。
7. 交付清单 —— 剪辑顺序、后期叠字清单、对白轨。
## 风格锁定
- 统一风格关键词:`first-person POV, handheld subjective movement, small jolts, documentary realism, natural light, low saturation, wet cold air, lived-in texture, worn fabric, practical interior light`
- 写实纪录片质感,自然光,旧物有磨损、潮气、灰尘和使用痕迹。
- 情绪靠物理证据,不靠形容词:压抑 = 低视点贴近物体表面 + 封闭边界 + 低沉环境声 + 犹豫的手;孤独 = 大量留白 + 视线没有落点 + 只听得见自己呼吸;温暖 = 热气模糊视线 + 暖光从物体表面漫开 + 手碰到热碗。
- 情绪与视觉对照:紧张用冷暗强反差、窄而倾斜的构图、快速不稳的运动;悲伤用冷色低饱和、柔散光、空构图、静止;平静用中性柔光、平衡构图。
- 必须避免:主角正脸或全身、可读的中文字、广告大片感、CG 渲染、动漫、煽情慢动作、夸张表演、过于干净的环境。
## 分镜与镜头规则
- 铁律:镜头就是主角的眼睛。只允许出现主角的手、鞋、袖口、胸前物件边缘,以及玻璃 / 黑屏手机 / 后视镜里模糊的倒影轮廓。
- 信息必须进入视野才算成立:关键道具要出现在主角看得见的地方,声音可以辅助但不能代替关键画面。
- 每个片段写全主观运动链:视线起点 → 声音或动作触发 → 视线转移 → 手部动作 → 视线落点。不允许没有起点的镜头。
- 不写「定格」「镜头推近」这类导演语言,改写成「视线停在……」「视线被……的声音拉过去」「手从画面右侧伸进来」。
- 片段之间靠视线落点和声音触发衔接,不靠跳切。上一片段的落点就是下一片段的起点。
- 单片段 5-10 秒,每段 2-3 个片段。前半段节奏紧,后半段放慢。
- 每段写清「剧情任务」:这一段改变了什么、继承了上段什么、为下段准备什么。删掉它如果什么都不坏,就合并或删掉。
- 动作分阶段写,不写精确秒数:第一阶段 / 第二阶段 / 最终阶段,每阶段包含视线位置、动作、可见的物理反馈、环境反应、留给下一阶段的状态。结尾停在视线落点或手的停顿上,不要以全身镜头收。
- 用户的修正意见是硬锁:说了「低头」,就全程低头。
- 分镜表字段:段 / 片段号 / 时长 / 剧情任务 / 视线链 / 动作阶段 / 声音证据 / 情绪 / 后期叠字。
## 提示词写法
- 参考图各司其职:每张参考图只负责一件事——角色入画方式、环境空间与光、主角手部动作、道具细节——并写明「只继承什么、不继承什么」。例如:道具图只继承车票的形状和纸质,不继承构图。
- 图片提示词结构:生成目标 + 主体 + 材质细节 + 姿态构图 + 背景 + 光线 + 禁止项。
- 图片示例(主角局部):纪实近景照片,一双十几岁少年的手,指甲缝有泥,袖口磨毛的旧校服,捏着一张折皱的长途车票,背景是公交车座椅边缘,阴冷晨光,只拍手部,不出现脸,无文字。
- 视频提示词结构:固定前缀 `first-person POV from [主角]; camera is his/her eyes; no external shot of [主角]` → 参考图分工 → 首帧与尾帧状态 → 动作阶段 → 运镜(起点 → 触发 → 转移 → 落点)→ 声音证据 → 光线质感 → 具体禁止项。
- 视频示例:first-person POV from the boy; camera is his eyes; no external shot of the boy. 图1 只继承车厢空间与冷光,图2 只继承手部与车票。第一阶段:视线低垂落在自己膝盖上捏着车票的手,车身一颠,手指收紧。第二阶段:视线被前方咳嗽声拉起,越过空座椅,落在车内后视镜里司机模糊的眼睛上。最终阶段:司机移开目光,视线回落到车窗雨痕上停住。<柴油发动机低吼,雨刮器摩擦声,老人轻咳>。禁止切到第三人称、禁止出现主角脸或全身、禁止可读文字、禁止背景音乐。
- 负面词要具体对应失败风险,不写「低质量、模糊、丑」这种空话;简单场景 10-20 条,复杂场景 30 条以上,最常见的问题放最前面。
- 手机屏、作业纸、姓名牌一律写「有痕迹但不可读,文字后期加」。
## 在 TVVV 上执行
- 配角、场景、道具、主角手部局部用 generate_image 先出,后面每个镜头 generate_video 都用 reference_images 带上同一个 图N,image_role 选 reference;片段之间需要无缝衔接时,用上一片段尾帧作为 first_frame。
- 参考图数量宁少勿多,职责冲突时拆开或减少,否则容易换脸。
- 默认图片模型 Nano Banana 2;视频模型 Seedance 2.5,画幅 16:9,单镜 5-10 秒,720p。
- 生成时只保留环境声;对白用 generate_speech 后期配,方言优先,不追求口型。默认不加配乐,所有片段完成后才考虑 generate_music。
- 一次回复最多 3-4 次工具调用,按段分批生成,每段结果回来先自检再继续。
- 结尾给交付清单:片段与视频对应表、剪辑顺序(片段间硬切,段与段之间 0.5-1 秒黑场表示时间跨度)、需要后期叠加的文字(作业纸、站牌、来电界面)、对白轨和静音留白点;提示用户去 TVVV 时间轴剪辑合成,配乐如有不超过环境声的 60%。
## 注意事项
- 第三人称泄漏:模型最爱偷偷拍出主角背影或全身。一旦出现整段重跑,不要靠裁切补救。
- 视线高度不对:孩子视角要低机位,成人正常高度,写进每条提示词。
- 模型自己编剧情:每个片段的动作必须写满,不给模型留即兴空间。
- 换脸:配角在不同片段长得不一样,先查是不是没带同一张参考图,或参考图太多互相污染。
- 情绪不够:先加声音、停顿、手的犹豫和真实噪声,最后才考虑对白、哭声或配乐。静默往往是全片最有力的一刻。
- 防抽卡闸门:主体不稳先别调氛围,空间不稳先别调运镜,材质错了别再堆电影感形容词;「电影感、高级、梦幻」都要翻译成看得见的形状、材质、光和动作。