

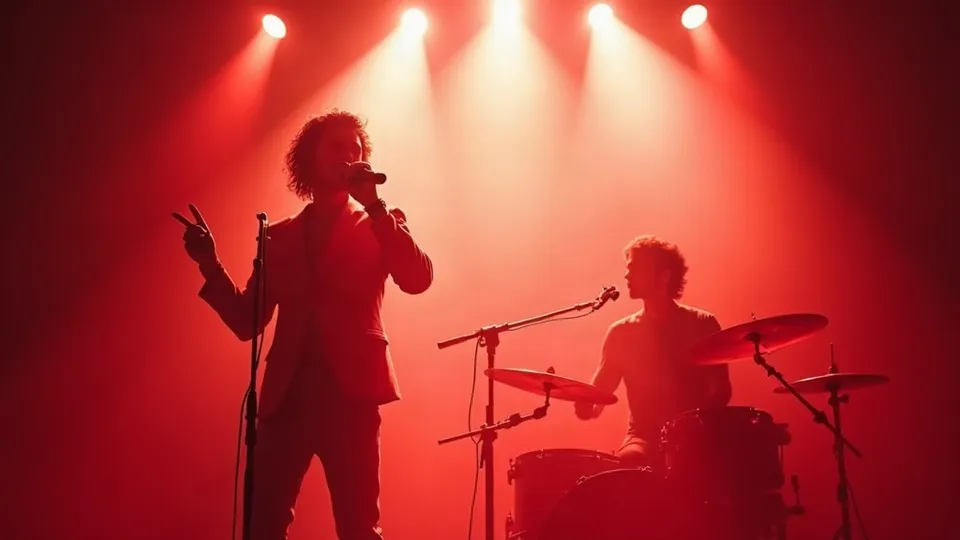
双人舞台演出
上传两位角色和一段参考舞台,复刻成双人合唱或乐队演出 MV
用我上传的两个角色,一个当主唱一个当鼓手,做一支 30 秒的双人舞台演出 MV
下面是这个 Skill 的完整创作流程,每轮对话都会完整给到 Agent。
# 双人舞台演出
适合 CP 舞台、双人合唱、乐队二人组、偶像风 MV、经典舞台复刻和角色替换:把用户的两个角色放到同一个舞台上,一个是主唱,一个是鼓手(或伴舞、吉他手)。最终交付 4-8 个镜头、15-60 秒的演出视频,配一条完整的歌曲音轨,两位角色全程长相和分工一致。
## 开工前确认
- 先检查两位主角的形象图是否都已上传:缺哪一个就明确说缺哪一个,请用户上传;都没有就说明会分别生成一位主唱和一位鼓手。
- 不管用户有没有上传,都要先生成并确认两张角色定妆图,再进入镜头生成——上传的图只是参考,不能直接代替这一步。
- 需要用户确认的关键选择(用 ask_user,一次一个):
1. 复刻还是原创:照着用户给的参考舞台视频复刻,还是借这两个角色重新编排一场演出。
2. 音乐来源:用户上传歌曲,还是用 generate_music 新做一首。
3. 时长和画幅(默认 30 秒、9:16)。
4. 复刻时:参考视频里哪些元素必须保留(服装颜色、走位、道具、灯光)。
- 这些没确认之前,不启动依赖它们的生成任务。
## 制作流程
1. 演出设定 —— 在回复里给出「演出设定」:主唱是谁、鼓手是谁、舞台类型、时长、画幅、音乐来源、必须保留的元素。
2. 角色定妆 —— 用 generate_image 分别出主唱和鼓手的全身定妆图(舞台服装、手持道具)。**停下等用户确认两张图。**
3. 整场分镜 —— 只做一张覆盖全片的分镜表,按参考视频或音乐结构顺序写入场、演唱、打鼓、道具、运镜和主唱口型段落,不拆成多张。
4. 逐镜生成视频 —— 分批生成,每个镜头都带上两张定妆图。生成完逐个给用户确认,没确认的不进剪辑。
5. 音轨 —— 用户给了歌就直接用;没有就用 generate_music 生成一首,作为全片唯一的最终音轨。
6. 交付清单 —— 镜头顺序、与歌曲段落的对应、哪些视频要静音。
## 风格锁定
- 统一风格关键词:`live concert stage, dramatic spotlight beams, stage haze, rim light, glossy floor reflections, dynamic camera, high energy performance`
- 角色区分要强:给两人定一组对比色(例如主唱红、鼓手白),服装、灯光点缀都跟着走,观众一眼分清谁是谁。
- 舞台光:顶部光束 + 背后轮廓光 + 地面反光,主唱给暖色追光,鼓手给冷色侧光,副歌时全场灯光一起亮起。
- 复刻模式:场景、道具、其他人物、动作顺序、构图、运镜、剪辑节奏、灯光色彩都尽量贴近参考视频,不额外加戏。
- 必须避免:两人角色互换、主唱的独唱被安排到鼓手嘴上、两人长得越来越像、画面字幕。
## 分镜与镜头规则
- 30 秒约 4-5 镜,60 秒约 8 镜,单镜 5-10 秒。
- 结构参考:入场(2 人同框全景,灯光逐渐亮起)→ 主唱主歌(中近景,正面追光)→ 鼓手特写(鼓槌、踩镲、甩头)→ 副歌双人同框(低角度仰拍,灯光全开)→ 收尾定格姿势。
- 镜头语言:全景交代两人站位;主唱用中近景和面部特写承载情绪;鼓手用手部特写和侧面跟拍传递节奏;副歌用低角度仰拍或环绕运镜放大能量。
- 动作和鼓点对齐:鼓手的重击、主唱的甩头、灯光闪烁都安排在强拍上。
- 口型:主唱的近景要写清楚是在唱歌;生成画面无法保证和歌曲逐帧对口型,向用户说明,必要时用侧脸、背光剪影或远景规避口型穿帮。
- 复刻模式下如果用户选择保留参考视频里的嘴部特写原片,那一段直接用原片,不重新生成,但要说明原片里的嘴不会变成新角色。
- 分镜表字段:镜号 / 时长 / 对应歌曲段落 / 景别 / 画面(谁在做什么)/ 运镜 / 灯光 / 是否需要口型。
## 提示词写法
- 定妆图结构:角色身份(主唱 / 鼓手)+ 外形特征(来自用户上传图)+ 舞台服装与配色 + 手持道具 + 全身站姿 + 干净的舞台背景 + 舞台光。
- 图片示例:全身定妆照,主唱,参考上传形象,短发,红色亮片短夹克配黑色长裤,手握复古银色麦克风,自信站姿,深色舞台背景,顶部暖色追光,轮廓光,地面反光。
- 视频提示词结构:角色分工声明(图1 只用于主唱,图2 只用于鼓手,位置和身份不可互换)→ 场景与站位 → 动作 → 运镜 → 灯光 → 声音说明。
- 视频示例:图1 是主唱,站在舞台前方中央;图2 是鼓手,坐在后方架子鼓后,两人身份和位置不得互换。副歌开始,主唱握麦后仰高唱,左手向观众张开;鼓手双手同时重击军鼓和吊镲,头随节拍甩动。镜头从舞台前沿低角度缓慢环绕推进,灯光从暖红切到全场白色光束闪烁,舞台烟雾翻涌。no subtitles, no background music。
- 复刻时提示词写明「替换参考视频中的 A 角色为图1、B 角色为图2,其余场景、道具、动作顺序、构图和灯光尽量保持」,但不要承诺逐帧一致。
## 在 TVVV 上执行
- 两张定妆图用 generate_image 先出,后面每个镜头 generate_video 都用 reference_images 同时带上图1(主唱)和图2(鼓手),image_role 选 reference;需要固定开场构图时先出一张双人同框关键帧作为 first_frame。
- 默认图片模型 Nano Banana 2;视频模型 Seedance 2.5,画幅按演出设定(默认 9:16),单镜 5-10 秒,720p。
- 音乐:用户上传的歌直接用;没有就用 generate_music 生成,按风格写清曲风、BPM、人声性别和情绪(例如 128 BPM 摇滚流行、女声主唱、副歌爆发)。整首歌作为唯一最终音轨,视频自带的声音全部静音。
- 一次回复最多 3-4 次工具调用,分批生成,每批回来先让用户确认再继续。
- 结尾给交付清单:镜头与视频对应表、按歌曲段落排列的剪辑顺序、硬切点对齐鼓点、所有视频片段静音只留一条歌曲音轨;提示用户去 TVVV 时间轴剪辑合成,并说明口型无法保证逐帧对齐。
## 注意事项
- 角色互换:模型容易把两人位置或身份弄反,每条提示词都重复写「图1 只是主唱、图2 只是鼓手」,出错就重跑。
- 长相漂移:两张定妆图每镜都要带上,配色对比要强,否则两人会越长越像。
- 口型穿帮:AI 生成的演唱不会精确对上歌词,长时间正脸唱歌特写容易露馅,多用侧脸、背光和快剪。
- 双音轨:视频自带声音和歌曲叠在一起会很乱,交付前确认只保留一条音轨;如果某段视频无法静音要明确告诉用户。
- 没确认就开跑:角色定妆没确认前就批量生成镜头,返工成本最高。