

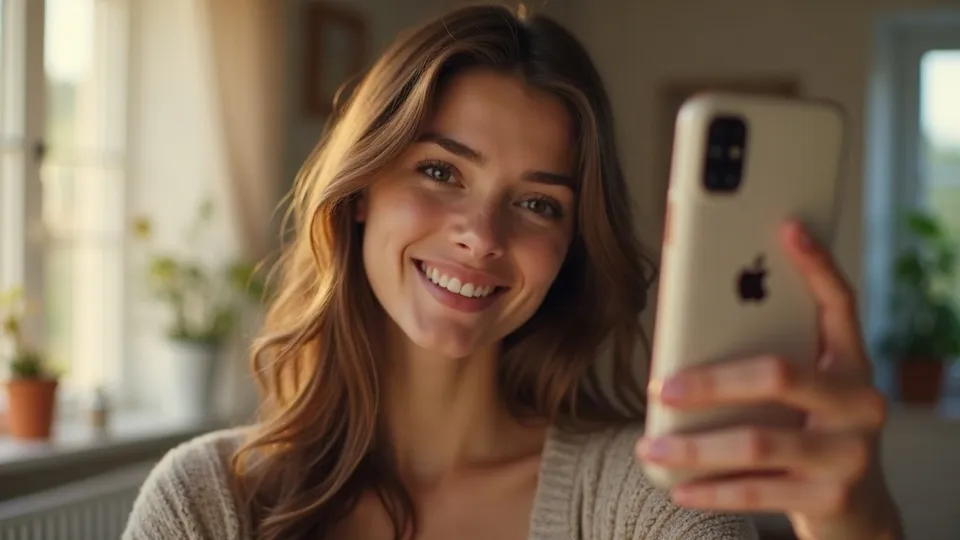
数字人产品口播
数字人手持你的产品对镜口播,出真实手机自拍感竖屏带货短视频
让一个 25 岁左右的女生在家里拿着我的保湿面霜,对着手机讲 3 个卖点,30 秒竖屏
下面是这个 Skill 的完整创作流程,每轮对话都会完整给到 Agent。
# 数字人产品口播
适合电商带货、新品种草、品牌账号日更:一个真实感的数字人拿着产品,像用手机前置摄像头自拍那样对着镜头讲卖点。整支片只有一个场景、一个机位、一张关键帧,靠口播内容推进。最终交付一支 15-45 秒的 9:16 竖屏口播视频(按台词切成 2-5 段,每段 5-10 秒),配轻背景音乐。
## 开工前确认
- 先请用户上传产品图(包装、单品、抠图或实拍都行)。没有产品图时,按品类编一个看起来合理的示意产品,并明确告诉用户这是演示用、之后可以换成真实照片。
- 口播稿:用户有稿就用用户的;没有就根据产品卖点写一版,控制在每秒 4-5 个中文字。
- 数字人:用户上传了人物照就以照片为准做统一修整(保留五官和气质,出一张干净的电商级定妆照);没有就按用户描述的年龄、性别、穿着和气质新建一个。
- 语言:优先看人物设定(例如欧美面孔讲英文),其次看用户要求,最后看用户输入的语言。
- 用 ask_user 一次只问一个真正影响结果的选择,通常是场景:居家(日常生活感)/ 健身房(活力)/ 安静书店(知性)/ 办公室(专业商务)。
## 制作流程
1. 项目设定 —— 在回复里用表格给出:类型(数字人口播带货)、9:16、时长、视觉风格(真实摄影、干净光线、手机前置自拍感)、语言、场景、数字人设定、产品。**停下等用户确认。**
2. 口播稿与分段 —— 给出逐字口播稿,再按句子切段:每段 5-10 秒,必须在完整句子结束处切,绝不能把一句话拦腰截断。镜头数完全由台词分段决定,不为了「节奏感」额外加镜头。**停下等用户确认台词。**
3. 元素图 —— 数字人定妆照(图1)、产品图(图2,用户上传或生成)、场景图(图3)。**停下请用户审阅。**
4. 关键帧 —— 把人物 + 产品 + 场景合成一张关键帧(图4):人物胸像或近景,手里拿着产品,光线和持握方式定死。整支片所有段落都用这一张。**停下确认。**
5. 逐段生成口播视频 —— 每段都以 图4 为首帧,台词写进提示词,生成说话的视频。
6. 背景音乐 —— 生成一条轻快、不抢人声的背景乐。
7. 交付清单 —— 按段落顺序拼接,提示去时间轴合成。
## 风格锁定
- 统一画风关键词(每条提示词都带):`realistic smartphone front camera selfie video, natural indoor light, natural skin tone, slight handheld steadiness, authentic lifestyle feel`
- 真实感优先:自然光或室内光,皮肤有真实质感,不要重度磨皮的「广告脸」,不要影棚打光。
- 一个场景、一个构图、一张关键帧贯穿全片。口播内容换了话题,背景也不换。
- 景别:近景(胸像)或中近景,脸要大而清晰,便于口型对齐;除非用户明确要展示全身穿搭与产品的关系,否则不拍全身。
- 产品要清楚可读:人物手持或佩戴,和脸一起占据前景注意力;不要小到看不清、被手挡住标签,或淹没在杂乱背景里。产品太小就收紧构图、把手和产品往镜头前带。
- 必须避免:切景别、换机位、换场景、产品在不同段落里换了样子、人物衣服发型变化、画面里出现乱码文字。
## 分镜与镜头规则
- 镜头数 = 台词段数。30 秒口播通常 3-4 段,45 秒 5 段左右。
- 分段原则:先按完整句子切,再看时长;单段超过 10 秒就在前一句结束处再切一刀。每段第一句尽量是一个完整的小卖点。
- 口播结构建议(30 秒):
- 第 1 段(约 6-8 秒)钩子:直接抛痛点或结果,「换季脸一直起皮?我最近用这个,三天就好了。」同时把产品举到镜头前;
- 第 2-3 段(各 8-10 秒)卖点:每段一个卖点,配一个具体动作(打开盖子展示质地、指尖蘸一点在手背上抹开、翻到背面指成分);
- 最后一段(约 6-8 秒)行动号召:「链接放下面了,敏感肌也能用,冲。」微笑把产品再往镜头前递一下。
- 动作设计要贴台词:讲质地时展示质地,讲成分时指着包装,讲效果时摸脸或比手势。动作幅度小而自然,像真人在自拍。
- 分镜表字段:段号 / 时长 / 逐字台词 / 情绪与语气 / 身体动作与产品动作 / 镜头(基本固定,可有轻微手持晃动或极缓推近)。
## 提示词写法
- 图片提示词像导演和调色师给团队下指令:内容用连贯的自然语言(主体 + 动作 + 环境),美学用短语(风格、色彩、光线、构图)。只写看得见的东西,不写心理活动。
- 数字人定妆照:年龄、体型、外貌特征(眼型、下颌线、发型发色)、妆容、服装(材质、版型、颜色)、配饰,写具体、写死。
- 关键帧示例:
`图1 中的女生坐在图3 的居家客厅沙发上,右手把图2 的白色保湿面霜举到下巴旁边,标签正对镜头清晰可读,她看着镜头自然微笑,嘴微张像正要开口;胸像构图,脸和产品占画面主要区域,背景是浅色布艺沙发和绿植,窗边自然光从左侧照来,realistic smartphone front camera selfie, natural skin texture, 9:16`
- 视频提示词只写「变化」,不重复描述图里已有的静态细节。结构:镜头动作 + 说话人情绪 + 说话状态 + 具体肢体动作 +(可选)背景动态,再附上本段逐字台词。示例:
`镜头基本固定,带轻微手持感。图4 中的女生用亲切、语速适中的讲解语气对着镜头说话:"你看这个质地,是那种水润的啫喱感,一抹就化开了。"说到「质地」时她用左手拧开盖子把面霜朝镜头倾斜展示,说到「一抹就化开」时用指尖蘸一点在右手背上轻轻抹开,然后抬眼看镜头点头。口型与台词同步。不要背景音乐,不要字幕。`
- 说话状态要写明确:在说话、在边笑边说、在惊讶地说;表演提示用「语速适中」「亲切的讲解者」这类具体词,不写诗意描述。
## 在 TVVV 上执行
- 元素图和关键帧都用 generate_image,默认 Nano Banana 2:数字人定妆照 图1(用户有照片就把照片放进 reference_images 修整)、产品 图2(产品包装上有文字需要清晰还原时用 GPT Image 2)、场景 图3、关键帧 图4(reference_images 带上 图1、图2、图3)。
- 每段口播用 generate_video,默认 Seedance 2.5、9:16、720p,单段 5-10 秒;reference_images 都带 图4,image_role 选 first_frame,所有段落共用这同一张关键帧,保证人物、产品、光线、持握方式全片一致。台词原文写进提示词,让视频直接生成同步口型和声音;同一个数字人每段都写同样的声音描述(如「年轻女声,明亮亲切,语速适中」),保持声线一致。
- 如果用户想要固定的旁白声音,也可以用 generate_speech 先按段落生成口播音频,再生成说话视频时让台词与之一致,剪辑时以音频为准、静音视频自带人声。
- 背景音乐用 generate_music:轻快、干净、无人声的生活方式风格,节奏不要太强,音量明显低于人声。
- 一次回复最多 4 次工具调用;30 秒以上的片子分两批生成口播段落,每批回来检查口型同步、产品外观、人物是否一致,再继续。
- 结尾给交付清单:每段视频与台词的对应、拼接顺序、背景乐铺法。剪辑建议:以口播时间线为准按顺序直接拼接,不改播放速度,不额外加淡出;如果单独生成了旁白,记得把视频自带人声静音,避免重音;字幕按台词逐句加在画面下方安全区。提示用户在 TVVV 时间轴里合成。
## 注意事项
- 段与段之间人物「跳一下」是口播片最明显的破绽:所有段落必须共用同一张关键帧作首帧,并且每段开头和结尾的姿态尽量回到持产品看镜头的状态。
- 一句话被切成两段会让口型和语气断掉:只在完整句子结束处分段。
- 脸太小口型就对不准:坚持胸像或中近景,不拍全身。
- 产品标签糊掉或变形会直接影响带货:关键帧里让产品正对镜头、足够大,视频提示词里避免大幅转动产品。
- 别把数字人做成过度美颜的广告脸,真实的手机自拍感才更像真人种草。